E資格(エンジニア資格)の勉強を進めていくと、どこかで「問題を解いて確かめたい」という段階に来ます。ところがここで、G検定とは事情が違うことに気づきます。
この記事では、2026年10月時点で一般社団法人日本ディープラーニング協会(JDLA)が公開している情報だけを土台に、シラバスの5ブロックに沿った予想問題10問と、分野ごとの解き方の型・間違えやすい論点を整理します。
この記事の問題について:本記事の10問は、JDLAが公開しているシラバス(試験出題範囲)の項目にもとづき、AI資格ナビ編集部が作成した予想問題(練習問題)です。実際に出題された問題ではなく、出題を予告するものでもありません。
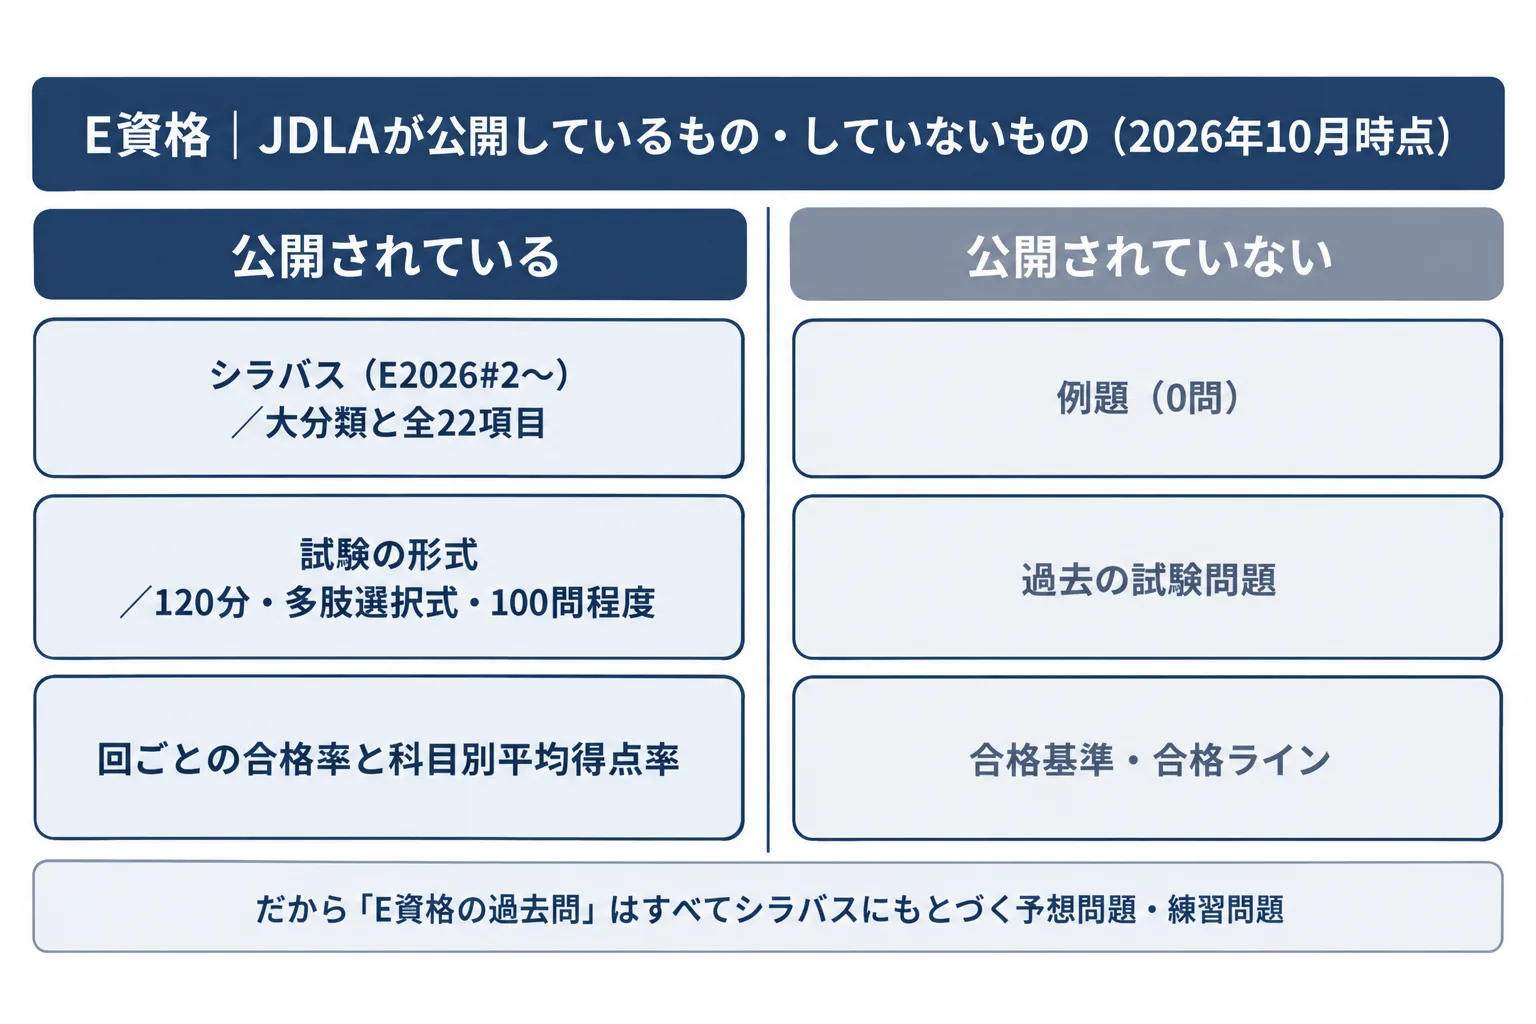
結論:E資格には公式の例題がない。だからシラバスから逆算するしかない
先に結論だけ書きます。JDLAはよくある質問で「E資格の例題はありますか?」という問いに対し、「E資格の例題は公開しておりません。何卒ご了承くださいませ。」と回答しています(2026年10月時点)。
これはG検定と対照的です。G検定には「G検定の例題・過去問」という公式ページがあり、シラバス10分野に分けた20問が公開されています。一方E資格については、例題が1問も公開されていません。
つまり、Web上や市販教材で「E資格の過去問」と銘打たれているものは、すべてシラバスの出題範囲にもとづいて各社・各著者が作成した予想問題・練習問題、あるいは受験者の記憶にもとづく再現だということになります。本記事の10問も同じ性質のもので、そのことを先に明示しておきます。
では、公式の例題がない状態で何を頼りに演習するのか。使えるものは3つあります。
- シラバスPDF:大分類と配下の項目名が公開されています。どの用語が範囲内かを判断する唯一の一次情報です。
- 試験の形式:試験時間120分、知識問題(多肢選択式・100問程度)という条件が公開されています。1問あたりに使える時間が決まります。
- 科目別の平均得点率:各回の結果発表で、応用数学・機械学習・深層学習・開発環境の4科目について公表されています。受験者がどこで点を落としているかが読めます。
この3つから逆算して問題を組み、解き方の型を言葉にしておく。それが公式例題のない試験に対する現実的な準備になります。
問題を解く前に押さえる、試験の事実(2026年10月時点)
演習の進め方は試験の形式で変わります。先にJDLA「E資格とは」および各回の結果発表で公開されている条件を確認します。
- 受験資格:JDLA認定プログラムを、試験日の過去2年以内に修了していること。
- 試験時間:120分。
- 出題形式・出題数:知識問題(多肢選択式・100問程度)。
- 直近回の実績:2026年第2回の結果発表には「120分の会場試験にて、105問を出題」と記載されています。
- フレームワーク:PyTorchまたはTensorFlowを利用した実装も扱われ、受験開始時にどちらかを選択します。
- コードの記述言語:JDLAは「ソースコードを含む問題については、Pythonで記述、またはフレームワークを利用した問題を出題します」と記載しています。
- 受験料(税込):一般33,000円/学生22,000円/会員27,500円。
- 出題範囲:現行はシラバスE2026#2〜。2026年8月開催の回から適用されています。
- 合格基準:公式ページに記載はありません。
- 次の開催:2027年第1回は2027年2月19日〜21日、第2回は2027年8月27日〜29日と発表されています。
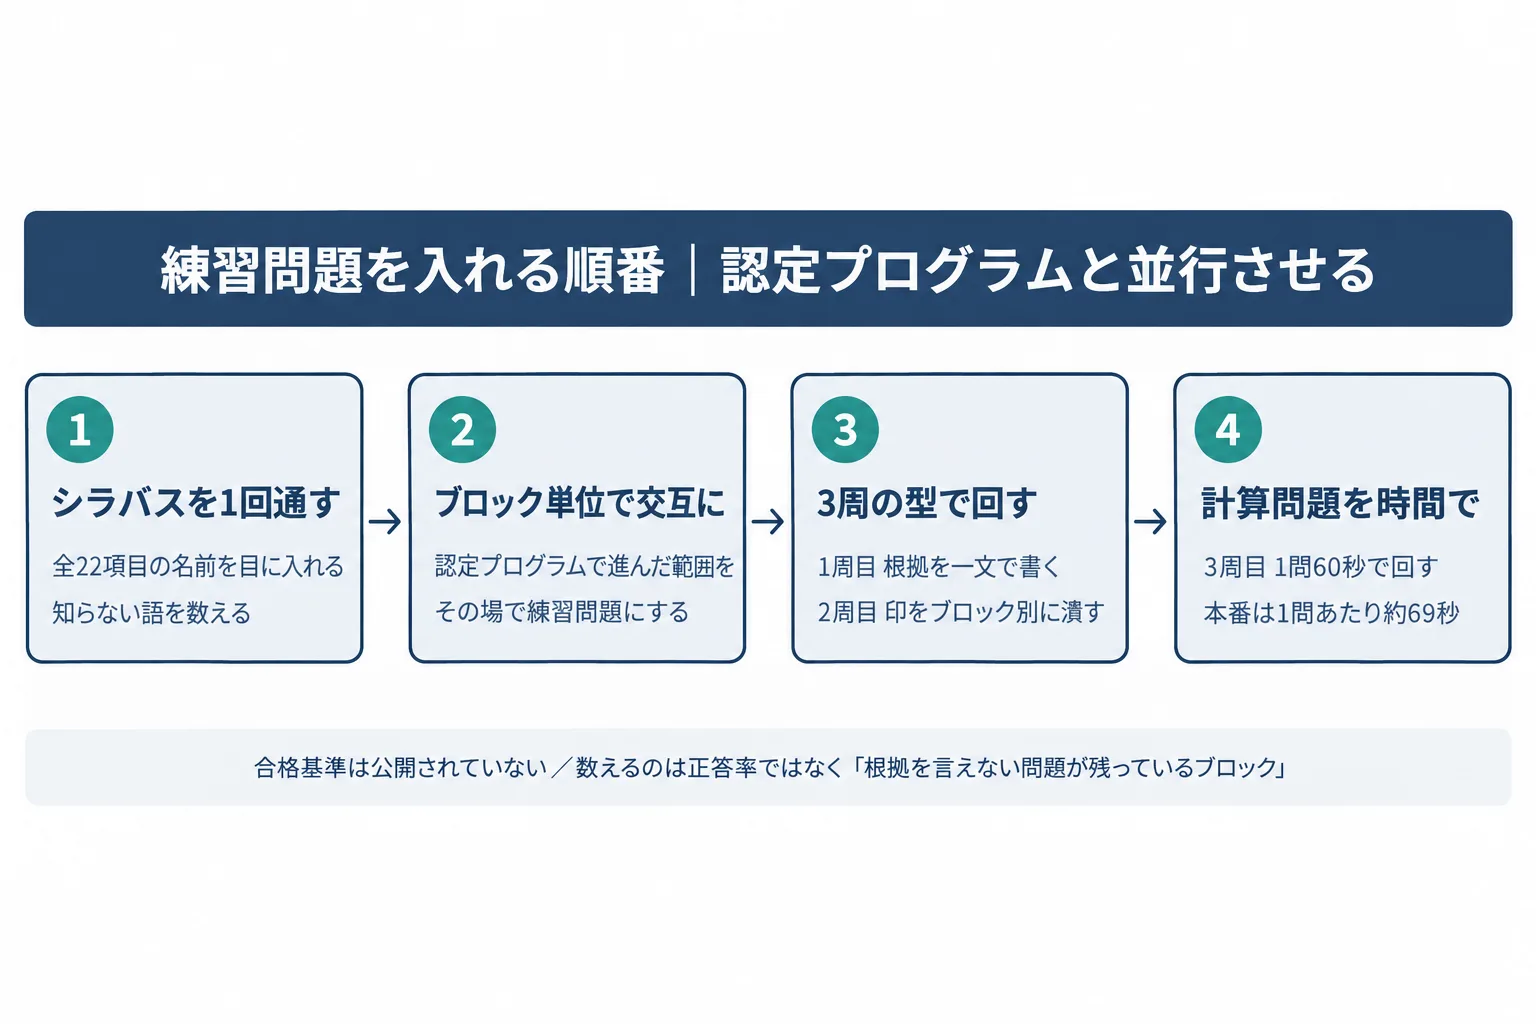
ここで演習に直結するのは、合格基準が公開されていないことです。「何割取れば合格」という公式の基準がないので、練習問題の正答率を目標に置いても判断材料になりません。使うなら点数ではなく「根拠を言えずに選んだ問題が、どの分野に何問残っているか」を数えてください。合格率そのものの推移はE資格の難易度と合格率|回ごとの受験者数と合格ラインの見方で扱っています。
もう1つ、どの分野を厚くするかの手がかりになるのが科目別平均得点率です。2026年第2回は応用数学60.90%、機械学習60.07%、深層学習62.32%、開発環境70.00%と発表されました。この回は開発環境だけが70%台で、他の3科目は60%前後に並んでいます。範囲が4項目と狭いぶん、開発環境は対策の効果が出やすい科目である可能性があります。逆に言えば、開発環境は取り切る前提で組み、数学と機械学習の土台を厚めにという配分になります。本記事の10問の内訳も、この読みに合わせています。過去の回を含めた推移はE資格の出題範囲(シラバス)を分野別に解説|配分の見方で扱っています。
出題範囲の地図|シラバス5ブロックと、分野ごとに間違えやすい論点
E資格のシラバスは「数学的基礎」「機械学習」「深層学習の基礎」「深層学習の応用」「開発・運用環境」の5ブロックで構成されています。ブロック名と配下の項目名はJDLAの公開情報どおりに並べ、右の2列(間違えやすい論点・本記事の問番号)は当編集部が整理したものです。JDLAの公表値ではありません。
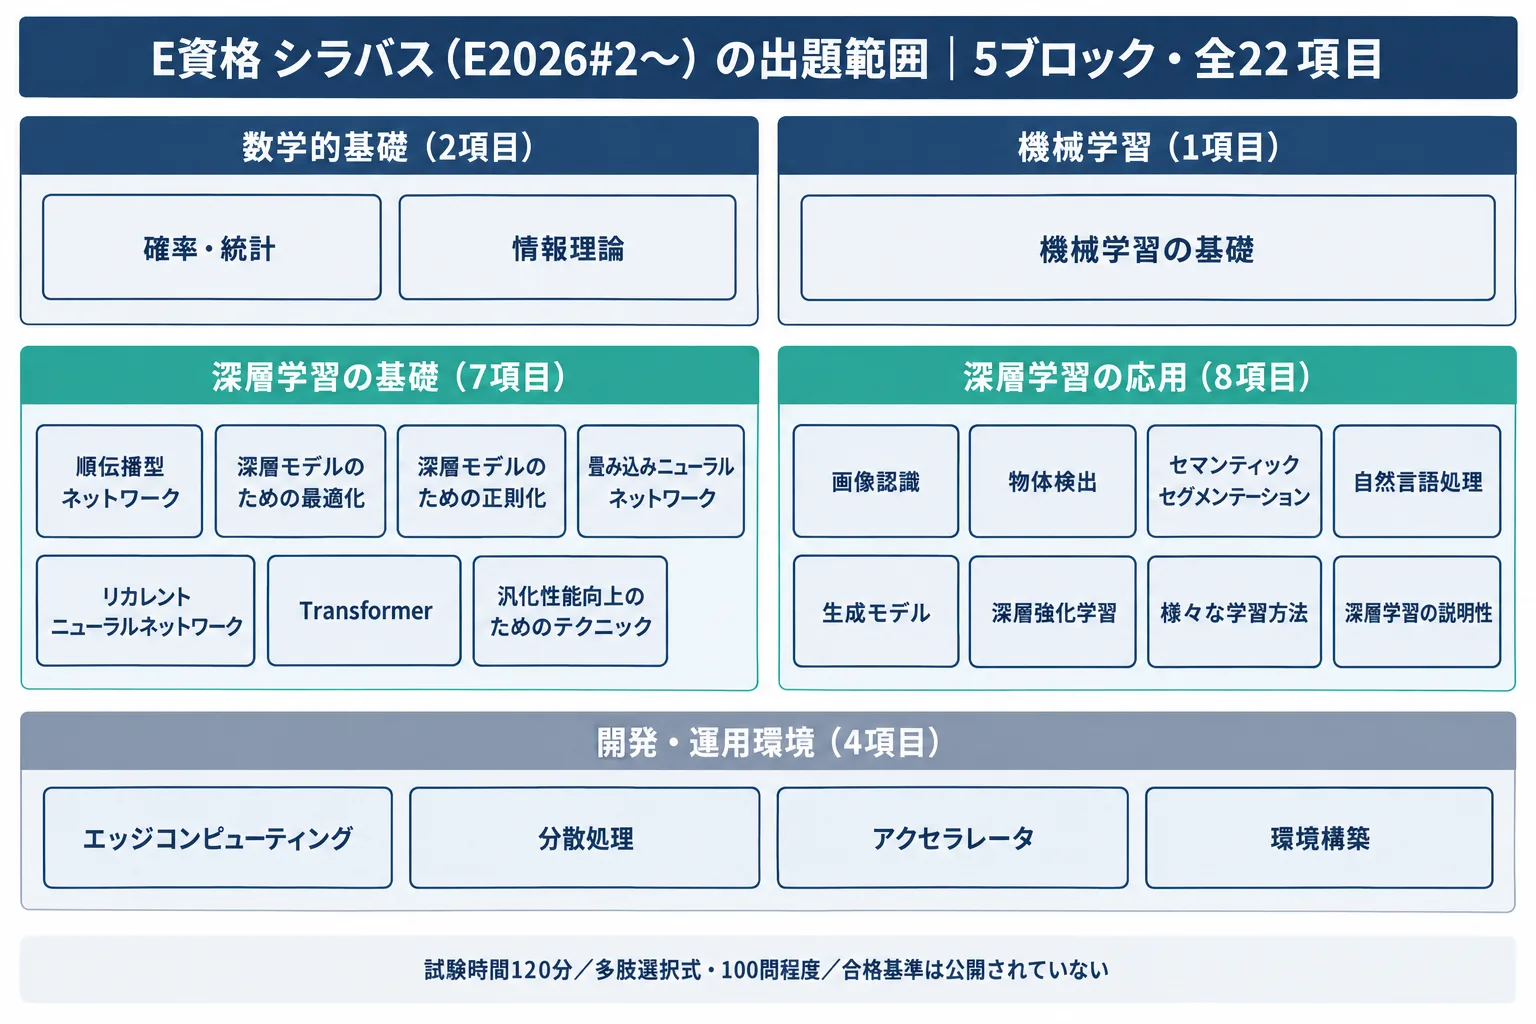
| ブロック | 配下の項目 | 間違えやすい論点 | 本記事の問 |
|---|---|---|---|
| 数学的基礎(2項目) | 確率・統計、情報理論 | 確率と確率密度の混同。仮定した分布と損失関数の対応を暗記で済ませる。KLダイバージェンスを「距離」として扱う | 問1・問2 |
| 機械学習(1項目) | 機械学習の基礎 | 前処理と評価の順序(データリーク)。正則化がバイアスとバリアンスのどちらを動かすかの向き | 問3 |
| 深層学習の基礎(7項目) | 順伝播型ネットワーク、深層モデルのための最適化、深層モデルのための正則化、畳み込みニューラルネットワーク、リカレントニューラルネットワーク、Transformer、汎化性能向上のためのテクニック | 最適化手法の系譜(何の移動平均を使うか)の取り違え。出力サイズ・パラメータ数の計算で入力チャネル数やパディングを落とす。Self-Attentionが順序情報を持たないことの理解 | 問4・問5・問6 |
| 深層学習の応用(8項目) | 画像認識、物体検出、セマンティックセグメンテーション、自然言語処理、生成モデル、深層強化学習、様々な学習方法、深層学習の説明性 | 評価指標と後処理の役割の取り違え。生成モデルの目的関数の混同(VAEとGANの構成要素が混ざる)。説明性の手法を「内部を使う/入力をいじる」で分けられない | 問7・問8・問9 |
| 開発・運用環境(4項目) | エッジコンピューティング、分散処理、アクセラレータ、環境構築 | 学習の分散(データ並列・モデル並列)と推論の軽量化(量子化・プルーニング・蒸留)を同じ箱に入れる | 問10 |
項目数で見ると、深層学習の基礎(7項目)と応用(8項目)で全22項目の7割近くを占めます。ただし項目数の少なさは学習量の少なさを意味しません。「機械学習」はシラバス上1項目ですが、学習と評価の考え方という土台がここにまとまっています。ブロックごとの読み方はE資格の出題範囲(シラバス)を分野別に解説|配分の見方で詳しく扱っています。
予想問題10問|分野別に、解き方の型つき
ここからが本題です。数学的基礎から2問、機械学習から1問、深層学習の基礎から3問、深層学習の応用から3問、開発・運用環境から1問の、計10問を用意しました。繰り返しますが、実際に出題された問題ではなく、シラバスの範囲にもとづく練習問題です。
解く順番の助言を1つ。選択肢を読む前に問題文だけを読み、「何と何を区別させようとしている問題か」を言葉にしてください。それができれば、残りは消去法でほぼ決まります。解答のあとに付けた「解き方の型」は、その言葉にする作業そのものです。
問1(数学的基礎|確率・統計)
回帰問題において、観測ノイズが平均0・分散一定の正規分布に従うと仮定したとき、パラメータの最尤推定が二乗誤差の最小化と一致する。その理由として最も適切なものを1つ選べ。
ア. 対数尤度を書き下すとパラメータに依存しない定数項と残差平方和の項に分かれ、対数尤度の最大化が残差平方和の最小化と同値になるため
イ. 正規分布の確率密度関数の値が常に区間[0,1]に収まるため
ウ. 最尤推定は損失関数を用いない推定法であり、二乗誤差とは本来無関係だが、結果が偶然一致するため
エ. 中心極限定理により、サンプル数が十分であればどのような損失関数も二乗誤差に収束するため
答え:ア
解き方の型:この種の問題は手順が固定です。①どんな確率分布を仮定したかを確認する ②負の対数尤度を書く ③パラメータに依存しない項を落とす。この3手順で、仮定した分布と損失関数の対応が出てきます。正規分布なら二乗誤差、ベルヌーイ分布なら二値交差エントロピー、カテゴリカル分布なら交差エントロピーです。この対応を「暗記」ではなく「導出の結果」として持っておくと、損失関数の選択を問う問題も同じ型で解けます。
間違えやすい点:イは確率と確率密度の混同です。確率密度関数の値は1を超えることがあります(分散が小さい正規分布では、平均の近くで密度が1より大きくなります)。密度と確率を区別できているかは、この分野で繰り返し問われる軸です。
問2(数学的基礎|情報理論)
KLダイバージェンス DKL(p‖q) の性質として、最も適切なものを1つ選べ。
ア. 常に0以上で、2つの分布が一致するときに限り0になるが、一般に DKL(p‖q) ≠ DKL(q‖p) であり距離の公理は満たさない
イ. 対称性と三角不等式をともに満たすため、分布間の距離としてそのまま扱える
ウ. 負の値を取ることがあり、その符号から2つの分布の前後関係が分かる
エ. 交差エントロピーとは無関係に定義される量であり、両者の間に関係式は存在しない
答え:ア
解き方の型:情報理論の問題は、関係式を1本押さえると連鎖的に解けます。覚えるのは「交差エントロピー = エントロピー + KLダイバージェンス」、つまり H(p, q) = H(p) + DKL(p‖q) です。分類タスクで正解ラベル p が one-hot のとき H(p) = 0 なので、交差エントロピーの最小化はKLダイバージェンスの最小化と一致します。損失関数に交差エントロピーを使う理由を説明する問題は、ここに帰着します。
間違えやすい点:イの「距離として扱える」です。非対称であることが重要で、だからこそ対称化した版(Jensen-Shannonダイバージェンス)が別の名前で用意されています。選択肢に「距離」という語が出てきたら、対称性と三角不等式を満たすかを確認する癖をつけてください。
問3(機械学習|機械学習の基礎)
手元のデータ全件を使って特徴量の標準化(平均0・分散1に変換)を行ったあと、同じデータでK分割交差検証を実施した。この手順の問題点として最も適切なものを1つ選べ。
ア. 検証用に分けられるデータの統計量(平均・分散)が変換を通して学習側に混入するため、汎化性能を楽観的に見積もることになる
イ. 標準化は線形変換であり、交差検証の前に行っても後に行っても結果は変わらないため、問題はない
ウ. 標準化によって検証に使えるデータ件数が減るため、評価のばらつきが大きくなる
エ. 標準化を先に行うと学習が収束せず、損失が発散する
答え:ア
解き方の型:前処理の問題は「統計量をどのデータから計算したか」の一点に絞って考えます。原則は統計量の算出(fit)は学習用データだけ、変換(transform)は学習用と検証用の両方です。標準化・正規化だけでなく、欠損値の補完値、カテゴリ変数のエンコード、特徴選択、オーバーサンプリングも同じ扱いになります。分割の前に置いてよいのは、他の行の情報を使わない処理(1行だけで決まる変換)だけです。
間違えやすい点:イは「線形変換だから順序を変えても同じ」という一見もっともらしい理屈です。変換そのものは線形でも、変換に使う平均と分散がどのデータから計算されたかが変わるため、結果は同じになりません。
問4(深層学習の基礎|深層モデルのための最適化)
最適化手法に関する記述のうち、最も適切なものを1つ選べ。
ア. Adamは勾配の一次モーメントと二次モーメントの指数移動平均を用い、学習初期の推定の偏りを補正する項を持つ
イ. Adamは学習率を内部で自動決定するため、学習率をハイパーパラメータとして指定する必要がない
ウ. モーメンタムは勾配の符号のみを利用し、勾配の大きさは利用しない
エ. AdaGradは勾配の二乗の指数移動平均を用いるため、学習率が単調に減少することはない
答え:ア
解き方の型:この分野は「何の移動平均(あるいは累積)を使うか」の一本の軸で系譜を並べられます。SGDは勾配そのまま、モーメンタムは勾配の一次モーメント、AdaGradとRMSPropは勾配の二乗(二次モーメント)、Adamはその両方にバイアス補正を加えたもの。この並びを書けるようにしておくと、手法名と性質を結ぶ問題はまとめて落とせます。
間違えやすい点:エはAdaGradとRMSPropの入れ替えです。AdaGradは勾配の二乗を累積するので分母が増え続け、実効的な学習率は単調に減少します。その点を改善するために指数移動平均に置き換えたのがRMSPropです。「累積」と「指数移動平均」のどちらかという違いだけで、2つの手法は区別できます。
問5(深層学習の基礎|畳み込みニューラルネットワーク)
サイズ32×32、チャネル数3の入力に対し、カーネルサイズ5×5、フィルタ数16、ストライド1、パディング2の畳み込み層を1つ適用する。出力の特徴マップのサイズ(高さ×幅×チャネル数)と、この層の重みパラメータ数(バイアスを除く)の組み合わせとして正しいものを1つ選べ。
ア. 32×32×16、1,200
イ. 28×28×16、1,200
ウ. 32×32×16、400
エ. 30×30×16、2,400
答え:ア
解き方の型:2本の式を手で書いてから数を入れます。
出力サイズ = (入力サイズ + 2×パディング − カーネルサイズ) ÷ ストライド + 1 = (32 + 4 − 5) ÷ 1 + 1 = 32。
重みパラメータ数 = カーネル高 × カーネル幅 × 入力チャネル数 × フィルタ数 = 5 × 5 × 3 × 16 = 1,200(バイアスを入れる場合はフィルタ数ぶんの16を足して1,216)。
出力チャネル数はフィルタ数と一致します。この2式は暗算できる状態にしておくと、時間を節約できます。
間違えやすい点:ウは入力チャネル数3を掛け忘れた値(5×5×16=400)です。1つのフィルタは入力の全チャネルにまたがる立体であることを押さえてください。イはパディングを0として計算した値です。選択肢が「正しい式に間違った数を入れた結果」で構成されるのが、計算問題の定番の作り方です。
問6(深層学習の基礎|Transformer)
Transformerのエンコーダで位置エンコーディング(Positional Encoding)が必要となる理由として、最も適切なものを1つ選べ。
ア. Self-Attentionは全トークン間の重み付き和として計算されるため、入力トークンの並び順を入れ替えても出力が対応して入れ替わるだけで、順序そのものの情報が表現に反映されないため
イ. Self-Attentionの計算量が系列長の2乗に比例するため、位置エンコーディングによって計算量を削減する必要があるため
ウ. 位置エンコーディングは勾配消失を防ぐための仕組みであり、残差結合を置き換える役割を持つため
エ. 位置エンコーディングは学習時にのみ必要で、推論時には取り外して使うため
答え:ア
解き方の型:「その演算は順序を見ているか」を自問します。RNNは前の時刻の状態を受け取って逐次処理するので、順序が計算の構造そのものに入っています。一方Self-Attentionは、各トークンが他の全トークンを参照する重み付き和なので、構造の中に順序がありません。だから順序情報を外から足す必要がある——この対比で覚えると、RNNとTransformerの違いを問う問題も同じ説明で片付きます。
間違えやすい点:イは正しい事実と誤った因果をつないだ選択肢です。Self-Attentionの計算量が系列長の2乗に比例するのは事実ですが、それは位置エンコーディングとは別の論点(長い系列を扱いにくい理由)です。「書かれていることは正しいが、問われていることの答えになっていない」選択肢は多肢選択式の定番なので、最後に問題文へ戻って答えになっているかを確かめてください。
問7(深層学習の応用|物体検出)
物体検出モデルの推論結果で、同じ物体に対して重複した検出枠が多数出力された。この重複を整理する後処理として最も適切なものを1つ選べ。
ア. NMS(Non-Maximum Suppression)を適用し、信頼度スコアの高い枠を残して、それとのIoUが閾値以上の枠を除去する
イ. 全結合層を追加し、重複した枠の座標を平均化して1つにまとめる
ウ. タスクをセマンティックセグメンテーションに切り替え、画素単位の予測に置き換える
エ. mAP(mean Average Precision)を計算し、値が閾値を下回る枠を除去する
答え:ア
解き方の型:物体検出は「候補領域を出す → クラスと枠を予測する → 重複を消す」の3段で捉えます。最後の段がNMSです。そして、この分野はIoU(=重なり面積 ÷ 和集合の面積)が何度も出てきます。NMSの閾値にもIoUが使われ、mAPの計算で「その枠を正解とみなすか」を判定するのにもIoUが使われます。1つの指標が後処理と評価の両方に顔を出すので、役割を分けて覚えてください。
間違えやすい点:エは評価指標を後処理に使ってしまう取り違えです。mAPはデータセット全体に対してモデルの性能を測る指標で、1枚の画像の推論結果を加工するものではありません。「指標」と「処理」を混ぜた選択肢は、応用ブロック全体でよく見かける作り方です。
問8(深層学習の応用|生成モデル)
VAE(変分オートエンコーダ)の学習で最大化される下限(ELBO)に含まれる項の組み合わせとして、最も適切なものを1つ選べ。
ア. 入力を復元できているかを測る再構成項と、潜在変数の近似事後分布を事前分布に近づける正則化項(KLダイバージェンス)
イ. 生成器の損失と識別器の損失の2項
ウ. 再構成項と、識別器を騙せたかを測る敵対的損失の2項
エ. 交差エントロピーの項のみで、正則化に相当する項は含まれない
答え:ア
解き方の型:生成モデルは「何を目的関数にしているか」で分類すると整理できます。VAEは対数尤度の下限(再構成項+KL項)の最大化、GANは生成器と識別器のミニマックス最適化、拡散モデルは各ステップで加えたノイズを予測する回帰です。目的関数が違えば、学習が不安定になる理由も生成結果の傾向も変わります。手法名を覚えるより、この1列を書けるようにするほうが応用が効きます。
間違えやすい点:イとウはGANの要素が混ざった選択肢です。標準的なGANには再構成項がありません(入力を復元する経路を持たないため)。逆に標準的なVAEには識別器がありません。「オートエンコーダ系だから再構成、敵対的学習系だから識別器」という対応を崩された選択肢に注意してください。
問9(深層学習の応用|深層学習の説明性)
画像分類モデルの判断根拠を可視化する手法であるGrad-CAMの説明として、最も適切なものを1つ選べ。
ア. 対象クラスの出力スコアに対する最終畳み込み層の特徴マップの勾配を重みとして特徴マップを加重和し、入力画像上のどの領域が判断に寄与したかをヒートマップとして示す
イ. 入力画像の領域を1つずつ遮蔽して出力スコアの変化を測り、その変化量を全領域について集めることで寄与を求める
ウ. 学習済みモデル全体を決定木に置き換え、判断根拠を木構造として示す
エ. モデルの全パラメータを可視化し、絶対値の大きい重みから順に並べて示す
答え:ア
解き方の型:説明性の手法は「モデルの内部を使うか、外から入力をいじるか」でまず二分します。勾配や中間層の出力を使う手法(Grad-CAM、Saliency Map)は内部を使う側で、モデルの構造を知っている必要があります。入力を摂動させて出力の変化を見る手法(Occlusion Sensitivity、LIME、SHAP)は外から扱う側で、モデルの中身を問わずに適用できます。この二分ができれば、手法名を4つ並べた選択肢問題は半分に絞れます。
間違えやすい点:イはOcclusion Sensitivity(遮蔽による感度分析)の説明です。どちらも最終的にヒートマップが出てくるため、出力の見た目だけで判断すると区別できません。「勾配を使っているか」が分かれ目です。
問10(開発・運用環境|エッジコンピューティング)
学習済みの深層学習モデルを、通信が不安定な現場に置かれたエッジデバイス上で推論させたい。方針として最も適切なものを1つ選べ。
ア. 量子化・枝刈り(プルーニング)・蒸留などでモデルを軽量化し、推論をデバイス上で完結させる
イ. デバイスは入力データの送信のみを行い、推論は毎回クラウド側で実行して結果を受け取る
ウ. バッチサイズを大きくして1回の推論で多数の入力をまとめて処理する
エ. データ並列によって複数デバイスに勾配を分散させ、推論を高速化する
答え:ア
解き方の型:このブロックは2つの軸で整理します。①学習の話か、推論の話か ②デバイス側か、クラウド側か。データ並列・モデル並列は学習を分散させる手法、量子化・プルーニング・蒸留は推論側のモデルを小さくする手法です。エはこの①を取り違えた選択肢で、「勾配」という語が出てきた時点で学習の話だと判定できます。
間違えやすい点:設問の制約を読み飛ばすことです。「通信が不安定」という条件がなければ、イのクラウド推論は一般には妥当な設計になり得ます。条件つきで最適解が変わる問題では、問題文の制約語(通信・遅延・電力・プライバシーなど)に先に線を引いてください。エッジで処理する理由がこの4語のどれなのかを言えると、この分野の問題は安定します。
1問あたり約69秒|時間配分と見直しの順番
公開されている数字から逆算します。試験時間は120分で、2026年第2回は105問が出題されたと発表されています。120分 ÷ 105問 = 約69秒、つまり1問あたり1分強です。公式の試験概要が示す「100問程度」で計算しても約72秒で、おおよそ同じ水準です。
この数字は演習の進め方を変えます。問5のような計算問題で式の形から思い出していると、1問で3分使ってしまいます。式を暗算で回せる状態にしておくのは、理解の問題ではなく時間配分の問題です。
1周目:時間を計らず、根拠を一文で書く
最初は時間を無視します。1問ごとに「なぜその選択肢を選んだか」を一文で書いてください。書けなかった問題は、正解していても未習得として印をつけます。合格基準が公開されていない試験では、点数よりこの印の数のほうが意味のある指標です。
2周目:印がついた問題を、ブロック単位で潰す
印を5ブロックに振り分けると、手薄な場所がたいてい1〜2ブロックに集まります。そこだけ認定プログラムの教材やシラバスPDFに戻ります。全ブロックを均等に回すより時間効率が上がります。
3周目:計算問題だけを抜き出して、1問60秒で回す
出力サイズ、パラメータ数、計算量、期待値といった手を動かす問題を抜き出し、時間を計って回します。ここで60秒を切れるようになると、本番で知識問題に時間を回せます。60秒で式が立たない問題は飛ばして次に進む練習も同時にしてください。
認定プログラムと並行して演習を入れるタイミング
E資格は受験資格そのものが認定プログラムの修了(試験日の過去2年以内)です。つまり多くの人は、プログラムの受講と試験対策を同時に進めることになります。練習問題を入れるタイミングは、ここに合わせるのが自然です。
順番として大事なのは、プログラムを修了してから演習に入るのを待たないことです。深層学習の基礎のうち畳み込みニューラルネットワークまで進んだら、その範囲の計算問題を解く。Transformerまで進んだら、そこを解く。ブロック単位で交互に進めるほうが、用語の切り分けが定着します。
そのうえで、修了後の期間の使い方には注意が必要です。修了日から2年間は受験資格が有効なので、仮に不合格だった場合もその期間内であれば再受験できます(JDLAは「JDLA認定プログラム修了後2年間は受験資格がございますので、修了日から受験日まで2年以内であれば再度E資格試験を受験することができます」と案内しています)。ただし試験は年2回なので、受けられる回の数は限られます。開催回と申込期間はE資格の試験日程と申込期間|2027年の開催回と修了の2年期限で確認してください。
勉強時間の目安と、認定プログラムの進度に合わせた週あたりの配分はE資格の勉強法と勉強時間の目安|認定講座と並行する進め方にまとめています。この記事では範囲と演習の中身に絞り、時間設計には立ち入りません。
よくある失敗4つ
失敗1:「E資格の過去問」を本物の過去問だと思って解く
JDLAはE資格の例題を公開していません(2026年10月時点)。したがって「過去問」と表示されているものは、シラバスにもとづく予想問題か、受験者の記憶にもとづく再現のいずれかです。後者は内容の正確さを誰も保証していません。出所が書かれていない問題を解くときは、答えの根拠を自分でシラバスの項目と教材に当たって確認してください。本記事の10問も、根拠はシラバスの項目名だけです。
失敗2:シラバスの適用回を確認しないまま古い問題集を回す
2026年10月時点で適用されているシラバスは「E2026#2〜」です。旧版(E2024#2〜、E2026#1まで適用)も別ファイルとしてダウンロードページに残っています。教材や体験談を参照するときは、どちらを前提にしているかを必ず確認してください。
失敗3:正答率で仕上がりを判断する
合格基準は公開されていません。練習問題で8割取れたことは、その問題集に対する正答率でしかありません。ブロックごとに「根拠を言えない問題が残っているか」で見てください。とくに計算問題は、答えが合っていても式を思い出すのに時間がかかっていたなら未習得として扱うほうが安全です。
失敗4:フレームワークを決めないまま実装問題に手を出す
E資格では受験開始時にPyTorchとTensorFlowのどちらかを選択します。両方を中途半端に触ると、どちらのコードも読み切れないまま本番を迎えます。練習の段階で片方に決めて、選んだ側のコードだけを読んでください。本記事の10問に実装コードを含めていないのは、フレームワークを選ばないと問題として成立しないためです。この部分は認定プログラムの教材で埋める範囲になります。
まとめ
2026年10月時点の整理です。JDLAはE資格の例題を公開していません。G検定には公式の例題20問がありますが、E資格には1問もありません。そのため「公式の問題で答え合わせをする」という準備の仕方は成り立たず、シラバスの項目名から問題を逆算してつくるしかありません。世の中にある「E資格の過去問」も、本記事の10問も、その性質のものです。
代わりに公開されているのは、シラバスPDF、試験の形式(120分・100問程度、直近回は105問)、そして回ごとの科目別平均得点率です。この3つから、どのブロックを厚くするか、1問にどれだけ時間をかけられるかが決まります。1問あたり約69秒という数字は、計算問題を暗算で回せる状態にしておく理由にもなります。
合格基準が公開されていないので、正答率を目標に置いても判断材料になりません。数えるべきは「根拠を言えずに選んだ問題が、5ブロックのどこに何問残っているか」です。印のついた問題がどのブロックにも残っていない状態が、範囲を一通り押さえた状態です。
よくある質問
Q1. E資格の過去問や例題は、どこかで手に入りますか。
2026年10月時点で、JDLAは「E資格の例題は公開しておりません」と明記しています。公式に公開されている問題はありません。また合格基準も公開されていないため、仮に問題を集められたとしても合否の基準を自分で再現することはできません。シラバスの項目を一次情報として、そこから逆算した予想問題・練習問題でブロックごとに潰していくのが現実的な進め方です。
Q2. 練習問題は何問くらい解けば足りますか。
公開されている合格基準がないため、「何問で足りる」とは言えません。問題数ではなくブロックで考えてください。シラバスの5ブロック全てについて、根拠を説明できる状態で解ける問題が続くようになっていれば、範囲としては一通り触れた状態です。逆に、何百問解いても特定のブロックに印が残っているなら、そこが未習得です。
Q3. G検定の予想問題を解くことは、E資格の対策になりますか。
用語の重なりはありますが、そのままでは足りません。E資格は認定プログラム修了レベルの問題が出題され、理論の導出や計算、実装の理解が問われます。本記事の問1(最尤推定と二乗誤差)や問5(出力サイズとパラメータ数)のような手を動かす問題は、G検定の演習では出てきません。両者の違いはG検定の予想問題10問|分野別の解き方と間違えやすい論点と見比べると分かりやすいです。そもそもどちらを受けるか迷っている段階であれば、E資格の受験資格と費用|JDLA認定プログラムが必須な理由と公開価格で受験の前提条件を先に確認してください。
あわせて読みたい
本記事の予想問題10問および解き方の型は、JDLAが公開しているシラバスの項目にもとづきAI資格ナビ編集部が作成した練習問題です。実際に出題された問題ではなく、出題を予告するものでもありません。試験の条件・日程・受験料・発表値は主催団体の公開情報によるもので、すべて2026年10月時点です。AI資格ナビはJDLAをはじめとする各主催団体とは関係のない非公式の情報サイトです。受験前に必ず公式サイトで最新の情報をご確認ください。