結論:まずJDLA公式の例題20問、次にシラバス準拠の予想問題
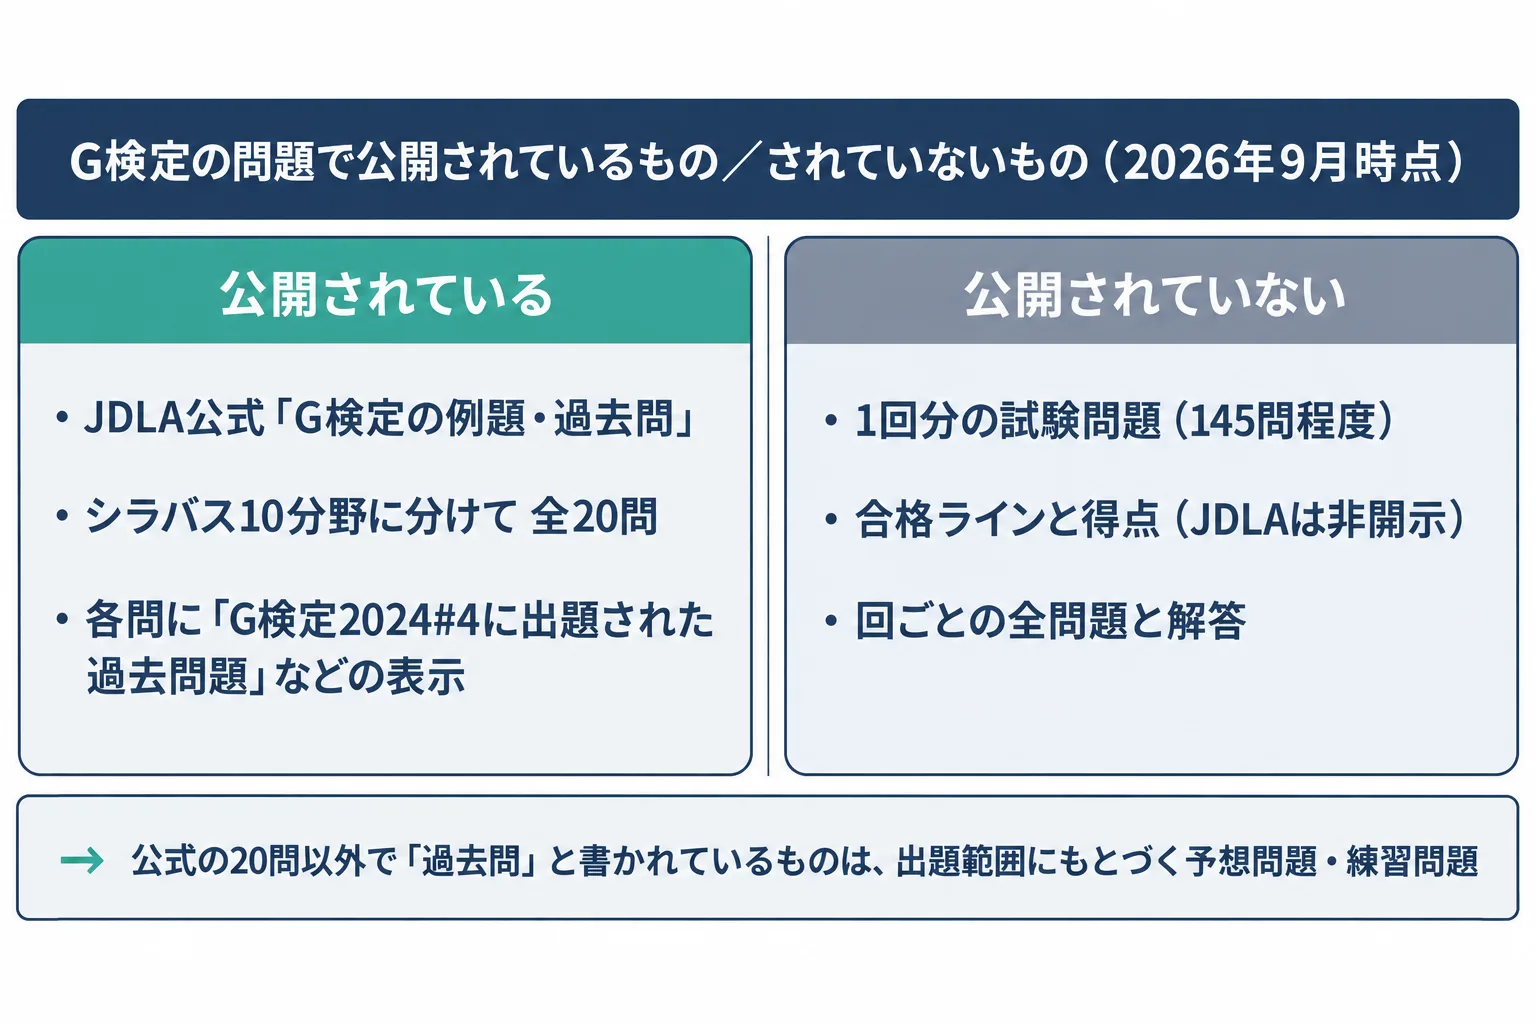
「G検定 過去問」で検索してたどり着いた方に、2026年9月時点の事実から先に書きます。G検定(ジェネラリスト検定)を主催する一般社団法人日本ディープラーニング協会(JDLA)は、公式サイトに「G検定の例題・過去問」というページを用意しており、シラバスの10分野に分けて全20問を公開しています。各問には「G検定2024#4に出題された過去問題」のように、どの回に出題されたものかが明記されています。
つまり「JDLAは過去問をまったく出していない」というのは正確ではありません。正確には、分野別の例題として20問が公開されている一方、1回分(145問程度)の試験問題がまるごと公開されているわけではない、という状態です。ですから、市販の問題集やWeb上で「過去問」と銘打たれているもののうち、公式の20問以外は、出題範囲(シラバス)にもとづいて各社・各著者が作成した予想問題・練習問題だと考えてください。
この記事では、順番として次の3つを渡します。①公式の例題20問をどう使うか。②シラバス10分野に沿った予想問題10問(当編集部が作成した練習問題)と、その解き方の型。③分野ごとに間違えやすい論点。
この記事の問題について:本記事の10問は、JDLAが公開しているシラバスの範囲にもとづき、AI資格ナビ編集部が作成した予想問題(練習問題)です。実際に出題された問題ではありません。また、JDLAの例題の文面はこの記事には転載していません。公式ページでご確認ください。
問題を解く前に押さえる、試験の事実(2026年9月時点)
予想問題の使い方は、試験の形式によって変わります。先にJDLAのG検定試験概要で公開されている条件を確認しておきます。
- 受験資格:制限なし。
- 出題形式:知識問題(多肢選択式)。
- 出題数:145問程度。
- 試験時間:オンライン試験100分/会場試験120分。
- 実施方式:オンライン実施(自宅受験)と、オンサイト実施(会場受験)。
- 受験料:一般13,200円(税込)/学生5,500円(税込)。
- 出題範囲:シラバス(G2024#6~)から出題。
- 実施回数:2026年はオンライン試験が年6回、会場試験が年3回(2026年の年間開催スケジュール)。
演習に直結する事実がもう1つあります。JDLAはG検定のよくある質問で「合格ラインおよび得点については開示しておりません。ご了承ください。」と明記しています。つまり「何割取れば合格」という公式の基準は存在しません。予想問題で8割取れたから安心、という判断は成り立たないということです。目安に使うなら、点数ではなく「分野ごとに、根拠を言えずに選んだ問題が何問あるか」を数えてください。
なお直近の結果として、2026年第3回は8,305名が受験し6,843名が合格(合格率82.40%。オンライン85.02%/会場70.29%)、2026年第4回は9,241名が受験し7,677名が合格(合格率83.08%)と発表されています。2026年第5回(会場試験9月4〜6日/オンライン試験9月5日)の結果は、2026年9月13日時点では発表されていません。
公式の例題20問の使い方|「答え合わせ」ではなく「分野の物差し」に使う
公式の例題20問は、分野ごとの内訳がはっきりしています。人工知能とは1問、人工知能をめぐる動向2問、機械学習の概要2問、ディープラーニングの概要2問、ディープラーニングの要素技術3問、ディープラーニングの応用例3問、AIの社会実装に向けて1問、AIに必要な数理・統計知識2問、AIに関する法律と契約2問、AI倫理・AIガバナンス2問の、合計20問です。
20問は試験1回分の約7分の1しかありません。ですから、これを「模試」として使うと情報量が足りません。使いどころは別のところにあります。
1. 問われ方の粒度を測る
同じ「畳み込みニューラルネットワーク」という用語でも、名前を答えさせる出題と、層の役割を区別させる出題では必要な理解の深さが違います。公式の例題は、JDLA自身が「この粒度で問う」と示したサンプルです。市販の問題集を買う前に20問を一度読み、自分の手持ちの教材が同じ粒度まで踏み込んでいるかを見比べてください。教材の選び方そのものはG検定の対策講座と教材の選び方|費用と認定の見方で扱っています。
2. 選択肢の作り方の癖を見る
多肢選択式では、正解そのものより「不正解の選択肢がどう作られているか」に情報があります。近い概念を入れ替える、条件を1つだけ強めに言い切る、範囲を広げすぎる——こうした作り方の癖は、例題を読むだけでも掴めます。
3. 10分野のどこが手つかずかを知る
各分野1〜3問しかないので、全分野に一度は触れられます。自分が「読んだこともない」分野を洗い出す用途には十分です。
出題範囲の地図|シラバス10分野と、分野ごとに間違えやすい論点
G検定のシラバスは、技術分野(Technology)8項目と、法律・倫理分野(Legal & Ethics)2項目の、合わせて10分野で構成されています。分野名と主な項目はJDLAの公開情報どおりに並べ、右端の「間違えやすい論点」は、各分野で概念の切り分けが必要になる箇所を当編集部が整理したものです。
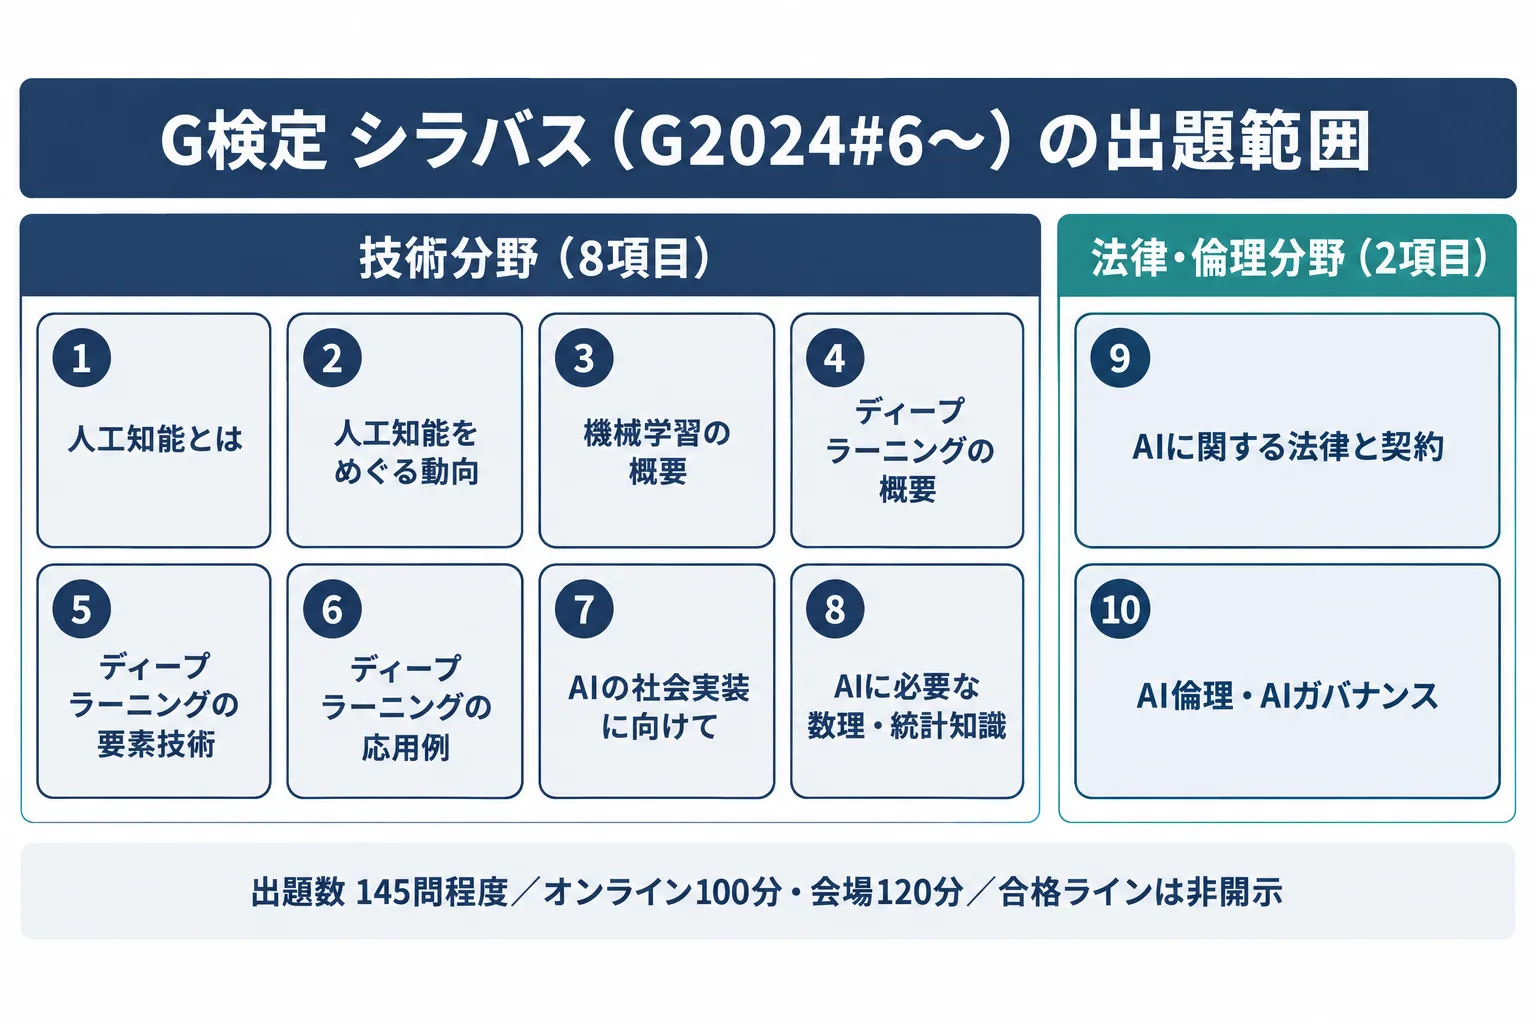
| 分野 | シラバスの主な項目 | 間違えやすい論点 |
|---|---|---|
| 1. 人工知能とは | 人工知能の定義、人工知能分野で議論される問題 | 「人間の受け取り方の問題」と「AI側の技術的限界の問題」の混同(AI効果/フレーム問題/シンボルグラウンディング問題) |
| 2. 人工知能をめぐる動向 | 探索・推論、知識表現とエキスパートシステム、機械学習、ディープラーニング | ブームごとの「主役技術」と「冬の原因」の対応がずれる(トイプロブレムと知識獲得のボトルネックの入れ替え) |
| 3. 機械学習の概要 | 教師あり学習、教師なし学習、強化学習、モデルの選択・評価 | 不均衡データで正解率だけを見る。適合率と再現率のどちらを優先すべきかの判断 |
| 4. ディープラーニングの概要 | 活性化関数、誤差関数、正則化、誤差逆伝播法、最適化手法 | 勾配消失の原因を「計算量」と取り違える。微分不可能な点を持つ関数の取り違え |
| 5. ディープラーニングの要素技術 | 全結合層、畳み込み層、正規化層、プーリング層、スキップ結合、回帰結合層、Attention、オートエンコーダ、データ拡張 | 層ごとの役割の混同。学習するパラメータを持つ層と持たない層の区別 |
| 6. ディープラーニングの応用例 | 画像認識、自然言語処理、音声処理、深層強化学習、データ生成、転移学習・ファインチューニング、マルチモーダル、モデルの解釈性、モデルの軽量化 | 「重みを動かす手法」と「モデルを小さくする手法」を同じ箱に入れてしまう |
| 7. AIの社会実装に向けて | AIプロジェクトの進め方、データの収集・加工・分析・学習 | 評価指標や撤退条件を決める順番。データ量を増やせば偏りが消えるという思い込み |
| 8. AIに必要な数理・統計知識 | 確率・統計、線形代数などの基礎 | 条件付き確率で基準率(有病率など)を無視する。相関を因果と読む |
| 9. AIに関する法律と契約 | 個人情報保護法、著作権法、特許法、不正競争防止法、独占禁止法、AI開発委託契約、AIサービス提供契約 | 学習(入力)段階の話と、生成・利用(出力)段階の話を混ぜる |
| 10. AI倫理・AIガバナンス | 国内外のガイドライン、プライバシー、公平性、安全性とセキュリティ、悪用、透明性、民主主義、環境保護、労働政策、AIガバナンス | 「〜だけで足りる」「〜と同義」のような言い切りを正しい記述として選ぶ |
表の10分野は、シラバスの並び順でもあります。学習の順番としても、1から順に進めるほうが用語の前提がそろいます。
予想問題10問|分野ごとに1問、解き方の型つき
ここからが本題です。10分野それぞれから1問ずつ、計10問を用意しました。繰り返しますが、これは実際に出題された問題ではなく、シラバスの範囲にもとづく練習問題です。
解く順番は、選択肢を読む前に問題文だけを読み、「何と何を区別させようとしている問題か」を言葉にしてみてください。それができれば、選択肢は消去法でほぼ決まります。
問1(人工知能とは)
次の記述に最もよく当てはまる用語を1つ選べ。
「人工知能で新しいことが実現され、その仕組みが分かってしまうと、それは単純な自動処理であって知能ではないと結論づけてしまう、人間の側の受け取り方の傾向」
ア. フレーム問題 イ. AI効果 ウ. シンボルグラウンディング問題 エ. 身体性
答え:イ
解き方の型:この分野の用語は「人間の側の話」か「AI側の技術的限界の話」かでまず二分できます。AI効果だけが人間の心理の話で、フレーム問題(考慮すべき事柄を無限に絞りきれない)、シンボルグラウンディング問題(記号と実世界の意味が結びつかない)、身体性(身体を通じた経験がないと概念をつかめない)はいずれもAI側の課題です。この二分ができれば、残り3つの細かい違いを思い出す必要がありません。
問2(人工知能をめぐる動向)
第二次AIブームを支えた技術と、その限界として指摘された問題の組み合わせとして、最も適切なものを1つ選べ。
ア. 探索・推論 ― トイプロブレム イ. エキスパートシステム ― 知識獲得のボトルネック ウ. ディープラーニング ― 勾配消失問題 エ. パーセプトロン ― 次元の呪い
答え:イ
解き方の型:ブームごとに「主役技術」「限界として指摘されたこと」の2点セットで覚えておきます。第一次は探索・推論で、現実の複雑な問題に適用できない(トイプロブレム)という限界。第二次は知識表現とエキスパートシステムで、知識を人手で書き出すコストが壁になった(知識獲得のボトルネック)という限界。第三次は機械学習・ディープラーニングです。
間違えやすい点:アの「探索・推論 ― トイプロブレム」は組み合わせ自体は正しいのですが、問われているのは第二次ブームです。組み合わせの正誤だけを見ると引っかかります。設問が限定している条件(ここでは「第二次」)に線を引いてから選択肢に入ってください。
問3(機械学習の概要)
1,000個に1個しか不良品が出ない検査工程で、不良品を「不良」と判定する二値分類モデルを作った。テストデータでの正解率(Accuracy)が99.9%だったが、この数値だけでは性能を判断できない。その理由として最も適切なものを1つ選べ。
ア. すべてを「良品」と判定するだけでも正解率は99.9%に達するため、不良品を見つける能力を表していない
イ. 正解率は回帰タスクにしか使えない指標であるため
ウ. 正解率は交差検証と併用できない指標であるため
エ. 正解率は学習データに対してのみ計算できる指標であるため
答え:ア
解き方の型:クラスの比率が偏っているデータ(不均衡データ)が出てきたら、正解率はいったん脇に置き、混同行列・適合率・再現率・F値で考えます。どちらを優先するかは「何を間違えると困るか」で決まります。見逃し(偽陰性)のコストが高い場面では再現率、誤検知(偽陽性)のコストが高い場面では適合率です。検査で不良品を見逃すのが困るなら再現率側です。
問4(ディープラーニングの概要)
層を深くしたネットワークで、隠れ層の活性化関数にシグモイド関数を使うと学習が進みにくくなることがある。その主な理由として最も適切なものを1つ選べ。
ア. シグモイド関数の導関数の最大値が0.25であり、層をさかのぼるほど勾配が小さくなっていくため
イ. シグモイド関数の出力が負の値を取るため、誤差が打ち消し合うため
ウ. シグモイド関数は微分できない点を持つため、誤差逆伝播法を適用できないため
エ. シグモイド関数は計算量が大きく、学習が時間内に終わらないため
答え:ア
解き方の型:勾配消失は「導関数の大きさ」と「層をさかのぼるときに掛け合わされる」の2点で説明できます。1より小さい数を何度も掛ければ0に近づく、という話です。ReLUが広く使われる理由も同じ枠で説明できます(正の領域では導関数が1なので、掛け合わせても小さくなりにくい)。
間違えやすい点:イとウは、別の関数の性質が混ざっています。シグモイド関数の出力は0〜1で負になりません(出力が-1〜1になるのはtanhです)。微分できない点を持つのはReLUのほう(x=0)で、それでも実用上は扱えます。このように「別の関数の特徴を正しい文章として混ぜる」のは多肢選択式の定番の作り方です。
問5(ディープラーニングの要素技術)
畳み込みニューラルネットワークにおけるプーリング層の役割として、最も適切なものを1つ選べ。
ア. 特徴マップを小さくまとめ、位置のわずかなずれに対する頑健性を高める
イ. 重みを学習し、入力の局所的な特徴を抽出する
ウ. 各層の入力の分布を整えて、学習を安定させる
エ. 前の層の出力を後ろの層へ直接足し込み、勾配を伝わりやすくする
答え:ア
解き方の型:この分野は層の名前と役割の一対一対応を作るだけで、かなりの問題に対応できます。イは畳み込み層、ウは正規化層(バッチ正規化など)、エはスキップ結合の説明です。最短の判別軸は「学習するパラメータを持つか」で、畳み込み層・全結合層は持ち、プーリング層は持ちません。
問6(ディープラーニングの応用例)
大規模なデータセットで学習済みのモデルを、手元の少量のデータで別のタスクに使いたい。「転移学習」と「ファインチューニング」の関係の説明として、最も適切なものを1つ選べ。
ア. 学習済み部分の重みを固定して付け足した層だけを学習させるのに対し、ファインチューニングは学習済み部分の重みも含めて更新する
イ. 転移学習は教師なし学習、ファインチューニングは教師あり学習である
ウ. 転移学習はモデルを軽量化する手法、ファインチューニングは精度を上げる手法である
エ. 転移学習は推論時に、ファインチューニングは学習時に行う手法である
答え:ア
解き方の型:「どこまで重みを動かすか」という一本の軸で並べます。軽量化(蒸留・量子化・プルーニングなど)は重みを動かす/動かさないの話とは別の箱なので、ウのように混ざった選択肢は外せます。
注意:転移学習とファインチューニングの線引きは、書籍や資料によって幅があります(ファインチューニングを転移学習の一形態として扱う説明もあります)。用語の定義が揺れる箇所は、JDLAが推奨している公式テキストの定義に合わせておくのが無難です。
問7(AIの社会実装に向けて)
AIプロジェクトの進め方に関する記述のうち、最も適切なものを1つ選べ。
ア. PoC(概念実証)では、どの指標がどの水準に達したら次の段階に進むのかを事前に決めておく
イ. 評価指標は技術検証が終わってから決めるのが原則で、企画段階では決めない
ウ. 学習データは量を増やせば、偏りは自動的に解消される
エ. 個人データを扱う場合でも、社内利用に限るなら利用目的の特定は不要である
答え:ア
解き方の型:この分野は「先に決めておくこと」が問われます。評価指標と撤退条件を先に決める、データの偏りは人が点検しないと消えない、法令上の義務は社内利用でも消えない——この3点を押さえると、イ・ウ・エのような選択肢はまとめて落とせます。
問8(AIに必要な数理・統計知識)
ある病気の有病率が1%の集団で、感度(病気の人を正しく陽性と判定する割合)99%、特異度(病気でない人を正しく陰性と判定する割合)95%の検査を行った。陽性と判定された人が実際にその病気である確率に最も近いものを1つ選べ。
ア. 約99% イ. 約67% ウ. 約17% エ. 約5%
答え:ウ
解き方の型:式を立てる前に、10,000人の表を書きます。病気の人は100人で、そのうち陽性になるのは99人。病気でない人は9,900人で、そのうち誤って陽性になるのは9,900×5%=495人。陽性は合計594人で、そのうち本当に病気なのは99人です。99÷594=約16.7%で、約17%になります。
間違えやすい点:感度99%を「陽性なら99%の確率で病気」と読み替えてしまう誤りです。元の集団での割合(基準率)が小さいと、偽陽性の絶対数が真陽性を上回ります。条件付き確率の問題は、割合のまま考えず人数に直すのが最短です。
問9(AIに関する法律と契約)
日本の著作権法のもとで、著作物を含むデータを機械学習の学習用に複製する場合についての記述として、最も適切なものを1つ選べ。
ア. 著作権法第30条の4により、情報解析などの目的であれば、著作権者の利益を不当に害することとなる場合を除き、原則として許諾を得ずに利用できる
イ. 学習に使う場合は、すべての著作物について事前に著作権者の許諾を得る必要がある
ウ. 学習済みモデルの出力は、既存の著作物に類似していても著作権侵害にはならない
エ. 営利目的の場合は、情報解析のための利用は一切認められない
答え:ア
解き方の型:この分野は「学習(入力)段階」と「生成・利用(出力)段階」を必ず分けて読みます。第30条の4は入力側の規定で、出力が既存の著作物に類似する場合の侵害の成否は別の問題です。ウはその切り分けを崩している点で誤りです。考え方の整理は文化庁「AIと著作権について」が一次情報になります。
間違えやすい点:「原則として許諾不要」を「何をしてもよい」と読むこと。享受を目的とする利用が併存する場合など、第30条の4が適用されない場合があります。「原則」と書かれていたら必ず例外があると考えてください。
問10(AI倫理・AIガバナンス)
AI倫理・AIガバナンスに関する記述のうち、最も適切なものを1つ選べ。
ア. 説明可能なAI(XAI)は、モデルの判断の根拠を人が理解できる形で示すための技術の総称である
イ. アジャイル・ガバナンスは、あらかじめ詳細な規則を固定し、運用開始後は変更しないという考え方である
ウ. 公平性の確保は学習データの偏りを点検すれば足り、運用開始後の監視は不要である
エ. 透明性の確保とは、モデルの内部構造をすべて公開することと同義である
答え:ア
解き方の型:倫理・ガバナンス分野は、選択肢の語尾で判別できることが多い分野です。「〜すれば足り」「〜と同義である」「一切」「必ず」のような言い切りは、ほぼ誤りの目印です。この分野の公式な考え方は幅を持たせた書き方になっているため、選択肢の側が言い切っていたら疑ってかかるのが合理的です。用語の意味を思い出せなくても、イ・ウ・エはこの基準だけで外せます。
1問あたり約41秒|時間配分と見直しの順番
公開されている数字から逆算します。オンライン試験は100分で145問程度なので、1問あたり100分÷145問=約41秒です。会場試験は120分なので約50秒になります。知識問題としては短くはありませんが、長文を読んでから考え始める余裕はありません。
この数字は、予想問題の解き方そのものを変えます。
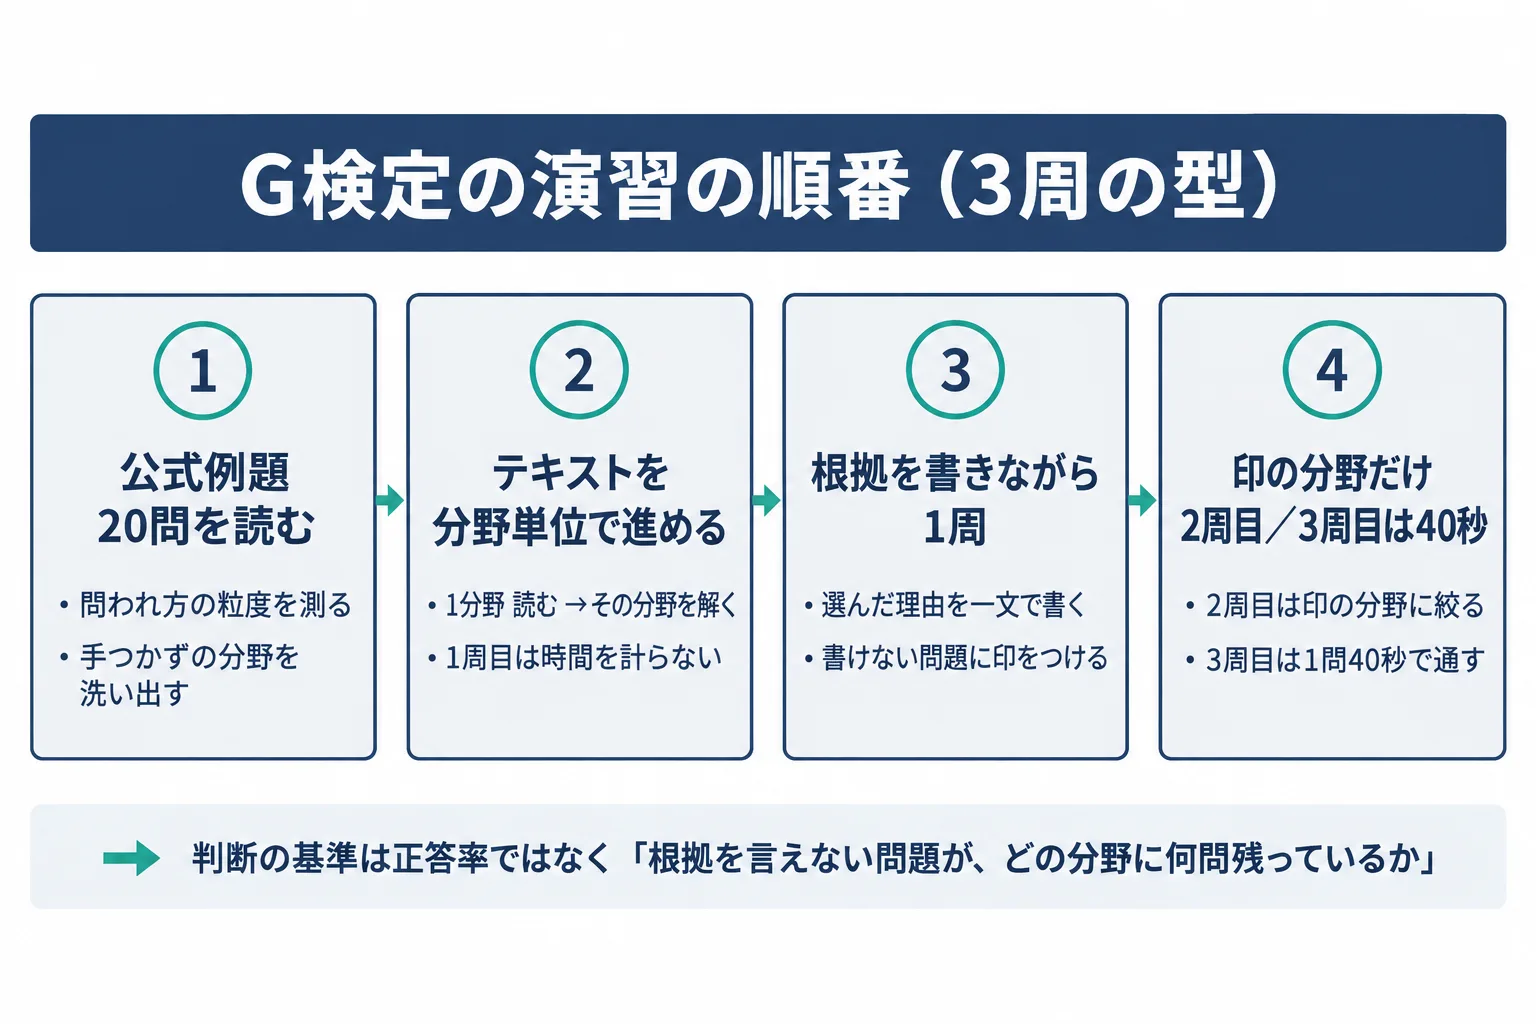
1周目:時間を計らず、根拠を言葉にする
最初は時間を無視してください。1問ごとに「なぜその選択肢を選んだか」を一文で書きます。書けなかった問題は、正解していても未習得として印をつけます。合格ラインが非開示である以上、点数よりこの印の数のほうが意味のある指標です。
2周目:印をつけた問題だけ、分野単位で潰す
印がついた問題を分野ごとに集めると、手薄な分野が1〜2つに絞られるのが普通です。そこだけテキストに戻ります。全分野を均等に回すより時間効率が上がります。
3周目:1問40秒を体に入れる
ここで初めて時間を計ります。40秒で決まらない問題は飛ばして次に進む練習です。オンライン試験は時間内に後から戻れる形式なので、「迷ったら飛ばす」を先に体で覚えておくほうが総得点は安定します。
学習時間の目安と、予想問題を入れるタイミング
JDLAはG検定の試験概要・学習方法のページで、合格者アンケートによる学習時間の分布を公開しています。最も多いのが「30〜50時間」で25.3%、次に「15〜30時間」が21.5%、「50〜70時間」が18.4%です。あくまで合格者の自己申告にもとづく分布であり、必要な時間を保証する数字ではありませんが、公表されている数字としてはこれが出発点になります。
仮に30〜50時間を前提に置くと、配分の目安は次のようになります。公式の例題20問と試験概要の確認に1時間。テキストを通して読むのに15〜25時間。予想問題・問題集の演習に10〜20時間。手薄な分野の復習に5時間前後です。
順番として大事なのは、予想問題に入るのをテキスト1周の後まで待たないことです。分野1〜3を読んだらその分野の問題を解く、というように分野単位で交互に進めるほうが、用語の切り分けが定着します。なお、JDLAは合格者が使った教材として「深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版」(2024年5月発売)などを挙げています。教材ごとの費用の考え方はG検定の対策講座と教材の選び方|費用と認定の見方にまとめました。
よくある失敗4つ
失敗1:「過去問」を名乗るものを本物の過去問だと思って解く
公式に公開されている過去問題は、例題ページの20問です。それ以外で「過去問」と表示されているものは、出題範囲にもとづく予想問題・練習問題か、受験者の記憶にもとづく再現である可能性があります。後者は内容の正確さを誰も保証していません。問題の出所が書かれていない教材は、答えの根拠を自分でテキストに当たって確認してください。
失敗2:シラバスの版を確認しないまま古い問題集を回す
2026年9月時点で適用されているシラバスは「G2024#6~」です。JDLAは旧版(G2024#5まで)も別ファイルとして残しているため、手元の教材がどちらを前提にしているかは必ず確認してください。古い版を前提にした問題集では、範囲のずれに気づけません。
失敗3:正答率だけを見て仕上がりを判断する
合格ラインは非開示です。模擬問題で8割取れたことは、その問題集に対する正答率でしかありません。分野ごとに「根拠を言えない問題が残っているか」で見てください。
失敗4:法律・倫理分野を後回しにする
シラバス10分野のうち2つが法律・倫理分野で、公式の例題20問のうち4問がここに割り当てられています。技術分野に比べて暗記量が少なく見えるため後回しにされがちですが、個人情報保護法・著作権法・各種ガイドラインは、用語を知っているだけでは選択肢を切れません。入力段階と出力段階の切り分けのように、読み方の型が必要な分野です。
まとめ
2026年9月時点の整理です。JDLAは公式サイトでシラバス10分野に分けた例題20問を公開しており、各問に出題回が明記されています。一方で、1回分145問程度の試験問題はまるごと公開されていません。だから「過去問を集める」のではなく、公式の20問で問われ方の粒度を測り、そのあとはシラバスに沿った予想問題・練習問題で分野ごとに用語の切り分けを確認する、という順番になります。
合格ラインも得点も開示されていないため、正答率を目標に置いても判断材料になりません。代わりに「根拠を言えずに選んだ問題が、どの分野に何問残っているか」を数えてください。時間配分はオンライン試験で1問あたり約41秒、会場試験で約50秒。この速度で迷わずに進める分野を増やしていくのが、演習の目的です。
企業として社員に受けさせる場合は、個人の演習とは別に、シラバスの版の確認と受験回の選び方が必要になります。その進め方は社員にG検定・E資格を取らせる進め方|費用と講座の選び方で扱っています。
よくある質問
Q1. G検定の過去問は、どこかで全部手に入りますか。
2026年9月時点で、JDLAが公開しているのは例題ページの20問です。1回分の試験問題がまとめて公開されている公式の場所はありません。また、JDLAは合格ラインと得点を開示していないため、仮に問題文を集められたとしても合否の基準を自分で再現することはできません。公式の20問を精読したうえで、シラバス準拠の予想問題・練習問題で分野をつぶすのが現実的な進め方です。
Q2. 予想問題は何問くらい解けば足りますか。
公表されている基準がないため、「何問で足りる」とは言えません。問題数ではなく分野で考えてください。シラバスの10分野すべてについて、根拠を説明できる状態で解ける問題が続くようになっていれば、範囲としては一通り触れた状態です。逆に、1,000問解いても特定の分野に印が残っているなら、そこが未習得です。
Q3. G検定の予想問題で練習すれば、E資格の対策にもなりますか。
重なる部分はありますが、そのままでは足りません。E資格(エンジニア資格)はJDLA認定プログラムの修了が受験の要件で、理論の理解と実装が問われる試験です。G検定の多肢選択式の演習とは求められるものが違います。両者の位置づけはE資格の難易度と合格率|回ごとの受験者数と合格ラインの見方とAI資格4つの違いと選び方|生成AIパスポート・G検定・E資格・DS検定で整理しています。