結論:DS検定に「過去問」はありません。協会公開の模擬問題10問から始めます
「データサイエンティスト検定 過去問」で探してたどり着いた方に、2026年9月時点の事実から先に書きます。データサイエンティスト検定 リテラシーレベル(以下、DS検定)を主催する一般社団法人データサイエンティスト協会は、過去に出題された問題を公開していません。公開されているのは、2026年6月2日付のお知らせで案内された模擬問題10問(PDF)です。
つまり、市販の問題集やWeb上で「DS検定の過去問」と銘打たれているものは、出題範囲(スキルチェックリストとモデルカリキュラム)にもとづいて各社・各著者が作成した予想問題・練習問題だと考えてください。
この記事では、順番として次の3つを渡します。①協会公開の模擬問題10問をどう使うか。②出題範囲の4領域に沿った予想問題10問(当編集部が作成した練習問題)と、その解き方の型。③領域ごとに間違えやすい論点。
この記事の問題について:本記事の10問は、データサイエンティスト協会が公開しているスキルチェックリストver.6と、数理・データサイエンス・AI(リテラシーレベル)モデルカリキュラムの範囲にもとづき、AI資格ナビ編集部が作成した予想問題(練習問題)です。実際に出題された問題ではありません。また、協会の模擬問題の文面はこの記事には転載していません。上記のPDFでご確認ください。
問題を解く前に押さえる、試験の事実(2026年9月時点)
予想問題の使い方は、試験の形式によって変わります。先に協会のDS検定★とは(試験概要と出題範囲)と、試験運営を担うCBT-Solutionsの受験者ページで公開されている条件を確認しておきます。
- 受験資格:なし。
- 出題形式:選択式問題。CBT-Solutionsの受験者ページでは「CBT四肢択一式100問100分」と案内されています。
- 問題数・試験時間:100問・100分。
- 実施方式:全国の試験会場で開催(CBT)。
- 受験料(税抜):一般10,000円/学生5,000円/大学会員学生4,000円。CBT-Solutions側の表示は税込で、一般11,000円/学生5,500円/大学会員4,400円(いずれも10%消費税込)です。
- 出題範囲:スキルチェックリストの4カテゴリ(基盤、データサイエンス、データエンジニアリング、価値創造)の★1(見習いレベル)と、数理・データサイエンス・AI(リテラシーレベル)モデルカリキュラム。
- 次回日程:第14回は試験期間2026年11月7日(土)〜11月22日(日)、個人申込は2026年9月21日(月)10:00〜10月23日(金)。
演習に直結する事実が2つあります。1つは電卓とメモ用紙が使えることです。CBT-Solutionsは「計算問題については、試験画面上に表示される電卓を利用することができます。」「会場にて筆記用具とメモ用紙をお渡しいたします。」と案内しています。計算問題は暗算で処理する前提ではない、ということです。
もう1つは合格ラインの扱いです。協会はよくある質問で合格ラインについて「非公開となっておりますため、予めご了承ください。」としています。一方で過去実施結果のページには回ごとの「合格ライン(正答率)」が参考値として掲載されており、第13回(2026年6月実施)は受験者数約2,220名・合格者数1,083名・合格率約49%・合格ライン約76%です。ページには「上記は過去参考値です。試験問題は各試験回によって少しずつ刷新されます」という注釈が付いています。回ごとの推移はデータサイエンティスト検定の難易度と合格率|回別の実績値にまとめました。
演習の目安としては、この参考値から「100問中おおむね76問前後」と置いておけば十分です。ただし確定した基準ではないため、正答率を目標に据えるより、後述する「根拠を言えずに選んだ問題の数」を数えるほうが判断材料になります。
協会公開の模擬問題10問の使い方|腕試しではなく「領域の物差し」に使う
協会の模擬問題は、2026年6月2日に ver.6 対応版として公開されたもので、お知らせには領域別の内訳が明記されています。「基礎:1問/価値創造:4問(2026年6月〜新設 解説付き)/データサイエンス:3問/データエンジニアリング:2問」の計10問です。
10問は本番100問の10分の1しかありません。ですから、これを「模試」として使うと情報量が足りません。使いどころは別のところにあります。
1. 問われ方の粒度を測る
同じ「相関」という言葉でも、用語の意味を答えさせる出題と、具体的な数値やグラフから解釈を選ばせる出題では、必要な理解の深さが違います。協会の模擬問題は、協会自身が「この粒度で問う」と示したサンプルです。教材を買う前に10問を一度読み、手元の教材が同じ粒度まで踏み込んでいるかを見比べてください。
2. 新設された「価値創造」の出方を確認する
10問のうち4問が価値創造で、しかもこの4問だけ解説が付いています。協会が試験範囲についてのお知らせで「価値創造スキルを問う問題が新規に加わります」と書いている領域であり、市販教材の対応が最も薄いところです。ここに解説が付いているのは、独学で最も助けになる部分です。
3. 手つかずの領域を洗い出す
4領域すべてに問題があるので、「読んだこともない」領域を見つける用途には十分です。逆に、10問の正答数で合否を占おうとしても意味はありません。
出題範囲の地図と、領域別の配分の手がかり
DS検定の出題範囲は2つの文書で決まります。1つはデータサイエンティスト協会のスキルチェックリストver.6(2025年12月公開。ビジネス力を価値創造力へ刷新し、基盤スキルと融合スキル群を新設、全体で650項目から845項目に拡大)の★1、もう1つはモデルカリキュラムです。範囲そのものの読み方と学習順はデータサイエンティスト検定の勉強法|出題4領域の順番と対策で扱っているので、ここでは解くときに必要な配分の情報だけに絞ります。
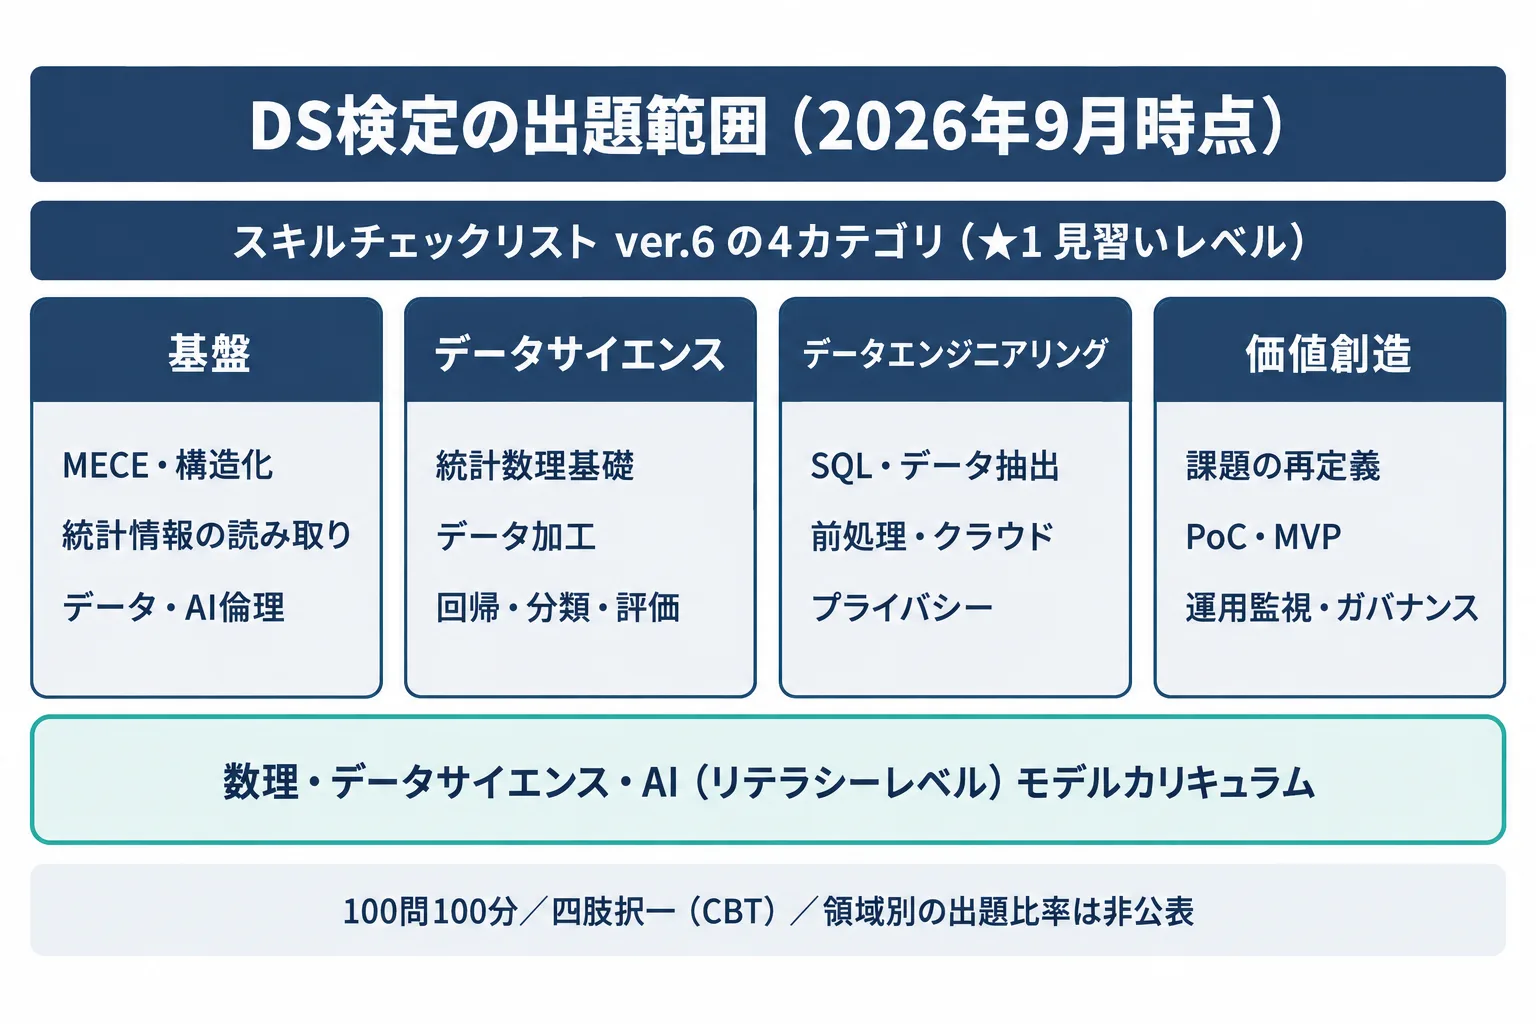
先に大事な前提を書きます。協会は本番100問の領域別の出題比率を公表していません。2026年9月時点で領域別の配分について公開されている手がかりは、模擬問題10問の内訳と、範囲変更のお知らせにある「従来のビジネス力を問う問題の多くは基盤スキルの問題に移行します」という記述の2つだけです。下の表の「協会の模擬問題」列は公表値、「本記事の予想問題」列は当編集部の配分です。本番の比率としては読まないでください。
| 領域 | スキルチェックリストver.6での位置づけ(サブカテゴリの例) | 協会の模擬問題10問 | 本記事の予想問題10問 |
|---|---|---|---|
| 基盤 | ver.6で新設。全データプロフェッショナルの共通土台。MECE、構造化能力、言語化能力、KPI、統計情報への正しい理解、データ・AI倫理、コンプライアンス、生成AI活用など | 1問(お知らせの表記は「基礎」) | 2問 |
| データサイエンス | 統計数理基礎、データ理解、データ加工、回帰・分類、統計的評価、機械学習、時系列分析、自然言語処理、大規模言語モデルなど | 3問 | 3問 |
| データエンジニアリング | データ抽出・収集・統合、テーブル設計、SQL、前処理、クラウド、プライバシー、認証、MLOps、生成AI活用など | 2問 | 2問 |
| 価値創造 | ver.6でビジネス力から刷新。未充足ニーズの洞察、戦略的価値設計、PoC設計・実装、MVP開発、運用監視設計、継続学習・改善、倫理・リスク設計、スケール設計など | 4問(解説付き・2026年6月〜新設) | 3問 |
本記事で基盤を1問増やし、価値創造を1問減らしたのは、協会が「従来のビジネス力を問う問題の多くは基盤スキルの問題に移行します」と明記しているためです。模擬問題の内訳をそのまま比率と受け取ると、基盤が1問しかないように見えてしまいます。
なお、サブカテゴリ名は協会がCSV版として公開しているスキルチェックリストver.6(CSV版)に掲載されているものから、★1に関係する範囲で抜き出したものです。融合スキル群はver.6で新設されたカテゴリですが、協会が示す試験の対象は上記4カテゴリのため、表には含めていません。
予想問題10問|領域別・解き方の型つき
ここからが本題です。4領域から計10問を用意しました。繰り返しますが、これはAI資格ナビ編集部が作成した予想問題(練習問題)であり、実際に出題された問題ではありません。
解くときは、選択肢を読む前に問題文だけを読み、「何と何を区別させようとしている問題か」を言葉にしてみてください。それができれば、選択肢は消去法でほぼ決まります。
問1(基盤/MECE)
ECサイトの会員を分析のために分類したい。MECE(モレなく、ダブりなく)になっている分け方として、最も適切なものを1つ選べ。
ア. 「20代」「30代」「40代」「学生」
イ. 「直近1年間に購入あり」「直近1年間に購入なし」
ウ. 「男性」「女性」「20代」
エ. 「メールマガジン登録者」「アプリ利用者」
答え:イ
解き方の型:3つの問いを順に当てるだけです。①分ける軸は1本か。②その軸で全員がどこかに入るか(モレ)。③2つ以上に入る人がいないか(ダブり)。イは「購入の有無」という1本の軸で、どの会員も必ずどちらか一方に入ります。アは「学生」が年代と重なり(20代の学生)、10代や50代以上がモレます。ウは年齢と性別の2軸が混ざっています。エは両方に該当する人も、どちらでもない人もいます。
間違えやすい点:軸が2本以上混ざっている選択肢は、中身を検討する前にその時点で外せます。まず軸の本数を数えるのが最短です。
問2(基盤/統計情報への正しい理解)
ある市のデータで「アイスクリームの売上が多い月ほど、水難事故の件数も多い」という関係が見つかった。この結果の解釈として最も適切なものを1つ選べ。
ア. アイスクリームの販売を抑えれば、水難事故は減る
イ. 2つの間に相関はあるが、気温という第三の要因が両方に影響している可能性がある
ウ. 相関係数が正の値であれば、因果関係があると判断してよい
エ. 水難事故の増加がアイスクリームの売上を押し上げている
答え:イ
解き方の型:相関の話が出たら、因果と断定する前に3つを思い出します。①第三の要因(交絡)がないか。②因果の向きが逆ではないか。③偶然ではないか。アとエは因果を前提にした選択肢、ウは相関から因果を導いてよいと言っている選択肢で、いずれもこの3点のどれかを飛ばしています。
間違えやすい点:「相関はあるが因果は不明」を「相関もない」と読み替えてしまうことです。この設問で否定されているのは因果の断定であって、相関そのものではありません。
問3(データサイエンス/代表値)
ある部署10人の年間残業時間(時間)は次のとおりだった。
10, 12, 12, 14, 15, 15, 16, 18, 20, 268
この分布の要約として最も適切なものを1つ選べ。
ア. 平均値は中央値より小さく、平均値のほうが部署の実態をよく表す
イ. 平均値は40.0時間、中央値は15時間で、極端な値の影響を受けにくい中央値のほうが「典型的な人」を表している
ウ. 同じ値が2回以上現れないため、最頻値は存在しない
エ. 極端な値が含まれているので、このデータは分析に使えない
答え:イ
解き方の型:極端な値が1つでもあったら、平均だけで語らない。平均と中央値の両方を出して差を見るのが型です。合計は400時間なので平均は400÷10=40.0時間。10人を小さい順に並べた5番目と6番目はどちらも15なので、中央値は15時間です。10人中9人が20時間以下なのに平均が40時間になるのは、268という1つの値が引き上げているからです。電卓が使えるので、この2つは必ず手を動かして出してください。
間違えやすい点:ウは12と15が2回ずつ現れているので誤りです。エのように「極端な値=除外すべき、使えない」と決めつけるのも誤りで、入力ミスなのか実際に起きた事象なのかで扱いは変わります。
問4(データサイエンス/評価指標)
製品1,000個で不良品検知モデルをテストしたところ、結果は次のとおりだった。
- 実際に不良品で、不良と判定:18個
- 実際に不良品だが、良品と判定:12個
- 実際は良品だが、不良と判定:72個
- 実際に良品で、良品と判定:898個
このモデルの再現率(Recall)として正しいものを1つ選べ。
ア. 20% イ. 60% ウ. 91.6% エ. 92.6%
答え:イ
解き方の型:混同行列の問題は、計算の前に「分母は実際の側か、判定した側か」を一言で決めます。再現率は「実際に不良品だったもののうち、何個を拾えたか」なので分母は実際の不良品の数=18+12=30。18÷30=60%です。適合率は「不良と判定したもののうち、本当に不良だった割合」なので分母は18+72=90で、18÷90=20%。この2つは分母が違うだけです。
間違えやすい点:アの20%は適合率、ウの91.6%は正解率((18+898)÷1,000)、エの92.6%は特異度(898÷970)です。不良品が1,000個中30個しかない不均衡なデータでは、正解率が9割を超えていても不良品の6割しか拾えていません。正解率だけを見て性能を判断しないのが、この分野の基本です。
問5(データサイエンス/学習の種類)
次のうち、教師なし学習に当たるものを1つ選べ。
ア. 過去の気温と来店客数の記録から、明日の来店客数を予測する
イ. 迷惑メールかどうかのラベルが付いたメールを学習し、新しいメールを振り分ける
ウ. 購買履歴から、事前に定義していない顧客のグループを見つけ出す
エ. 手書き数字の画像と正解の数字の組を学習し、未知の画像の数字を当てる
答え:ウ
解き方の型:判別の軸は「正解ラベルが与えられているか」の一点だけです。ア(回帰)、イ(分類)、エ(分類)はいずれも正解の付いたデータで学習する教師あり学習。ウはクラスタリングで、グループの定義そのものをデータから作ります。
間違えやすい点:「予測だから教師あり」「分類だから教師なし」と言葉の印象で覚えてしまうことです。分類にも教師ありのもの(イ・エ)とクラスタリング(ウ)の両方があります。迷ったら「学習に使うデータに答えが付いているか」に戻ってください。
問6(データエンジニアリング/SQL)
SQLの WHERE 句と HAVING 句の使い分けとして、最も適切なものを1つ選べ。
ア. WHERE は集約前の1行ごとの絞り込み、HAVING は GROUP BY で集約したあとのグループに対する絞り込みである
イ. WHERE は数値列に、HAVING は文字列の列に使う
ウ. HAVING は GROUP BY を書かなくても、1行ごとの絞り込みとして WHERE と同じように動く
エ. WHERE と HAVING は同じ機能で、どちらに書いても結果は変わらない
答え:ア
解き方の型:SQLの処理順を1本の線にして覚えておくと、この種の問題は位置関係だけで解けます。FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY の順です。SUM や COUNT などの集約結果で絞りたいなら HAVING、元の行の値で絞りたいなら WHERE、と対応させてください。
間違えやすい点:イのようにデータ型で使い分ける説明は、SQLの処理順とまったく関係がありません。選択肢が「数値/文字列」のような別の軸を持ち出してきたら、その時点で疑ってかかれます。
問7(データエンジニアリング/プライバシー)
個人情報保護法における「仮名加工情報」と「匿名加工情報」の違いの説明として、最も適切なものを1つ選べ。
ア. 仮名加工情報は他の情報と照合しない限り特定の個人を識別できないように加工したもので、法令に基づく場合などを除き第三者提供は認められない。匿名加工情報は特定の個人を識別できず、かつ元の個人情報を復元できないように加工したもので、含まれる項目と提供方法の公表など所定の手続を踏めば第三者提供ができる
イ. どちらも加工した時点で個人情報ではなくなるため、第三者提供は自由にできる
ウ. 仮名加工情報は復元できないように加工したもの、匿名加工情報は復元できるように加工したものである
エ. 氏名の列を削除すれば、いずれの情報にも自動的に該当する
答え:ア
解き方の型:2軸で並べると迷いません。①どこまで戻せないように加工したか(加工の強さ)、②誰に渡せるか(使える範囲)。この2つは連動していて、加工が強いほど外に出せる方向に動きます。仮名加工情報は加工が弱く社内利用が前提、匿名加工情報は加工が強く手続を踏めば外部提供ができる、という並びです。定義の確認は個人情報保護委員会のよくある質問が一次情報になります。
間違えやすい点:エのように「氏名を消せば個人情報ではなくなる」と考えることです。加工の基準は法令とガイドラインで定められており、列を1つ削除しただけで要件を満たすとは限りません。
問8(価値創造/課題の再定義)
事業部門から「解約しそうな顧客を予測するモデルを作ってほしい」と依頼された。プロジェクトの最初の段階として、最も適切な行動を1つ選べ。
ア. 依頼どおり、まず手元のデータで精度の高い予測モデルを作る
イ. 予測結果を受けて誰がどのような打ち手を実行するのか、その打ち手で何がどれだけ改善すれば成功とするのかを、事業部門と先に合意する
ウ. 予測精度の目標値は、モデルが完成してから実績をもとに決める
エ. 使ってよいデータの範囲は分析を進めながら判断すればよく、着手前の確認は不要である
答え:イ
解き方の型:ver.6で刷新された価値創造の領域は、「作る前に何を決めるか」を問う領域です。①この分析の結果で誰が何を決めるのか、②成功と判断する基準は何か、③使ってよいデータは何か。この3点を先に合意する側の選択肢を選ぶのが基本の型になります。
間違えやすい点:アは一見まじめですが、打ち手が決まっていないモデルは精度が高くても使われません。ウのように評価基準を後から決めると、精度が出たかどうかを判定する物差しが後付けになります。
問9(価値創造/PoCから本番展開へ)
PoC(概念実証)で良い結果が出た分析モデルを、全社展開しようとしている。この段階で検討すべき事項として、最も適切でないものを1つ選べ。
ア. 誰がデータを更新し、誰がモデルを再学習するのか、運用の担当と手順を決める
イ. PoCでは手作業で行っていたデータ加工を、定期的に自動で実行できる形にする
ウ. PoCで出た精度は本番でもそのまま出ると考え、展開後の効果測定は行わない
エ. 現場の業務手順のどこにモデルの出力を組み込むかを、利用部門と設計する
答え:ウ
解き方の型:「最も適切でないもの」を選ぶ設問は、まず設問の指示に線を引いてから選択肢に入ります。そのうえで、PoCと本番運用の違いを4点で持っておきます。①人手でやっていたことを繰り返せる形にする、②担当と責任を決める、③業務に組み込む、④効果を測り続ける。この4つのどれかを「やらない」と言っている選択肢が答えです。
間違えやすい点:設問が否定形であることを見落として、正しい記述であるアを選んでしまうミスです。時間に追われるほど起きるので、否定形の設問は問題文に印を付ける習慣にしてください。
問10(価値創造/運用後の監視)
本番運用を始めた予測モデルについての記述のうち、最も適切なものを1つ選べ。
ア. 運用開始後に入力データの傾向や利用者の行動が変化すると精度が徐々に低下することがあるため、精度と入力データの分布を継続的に監視する
イ. 精度が下がったときの再学習は、現場の担当者が違和感に気づいた時点で都度行えばよく、判断の基準を事前に決めておく必要はない
ウ. 運用中に発生した誤判定の記録は、学習に使ったデータではないため保存しなくてよい
エ. 予測処理を外部サービスのAPIに置き換えた場合、入力するデータの取り扱いについて自社で確認する必要はなくなる
答え:ア
解き方の型:運用フェーズの問題は4点セットで考えます。①環境は変化する、②だから測り続ける、③測る基準は先に決める、④記録を残す。「必要ない」「不要になる」「都度でよい」と書かれた選択肢は、このどれかを崩しているので外せます。
間違えやすい点:エのように「外部サービスに任せれば自社の確認は終わり」と読むことです。処理がどこで行われるかにかかわらず、何を入力してよいかの判断は利用する側に残ります。
1問あたり60秒|解く順番と時間配分
公開されている数字から逆算します。100問を100分で解くので、1問あたりちょうど60秒です。四肢択一で60秒は極端に短くはありませんが、問題文を読んでから考え始める余裕はありません。しかも計算問題では電卓を開く時間も含めて60秒です。
この数字は、予想問題の解き方そのものを変えます。
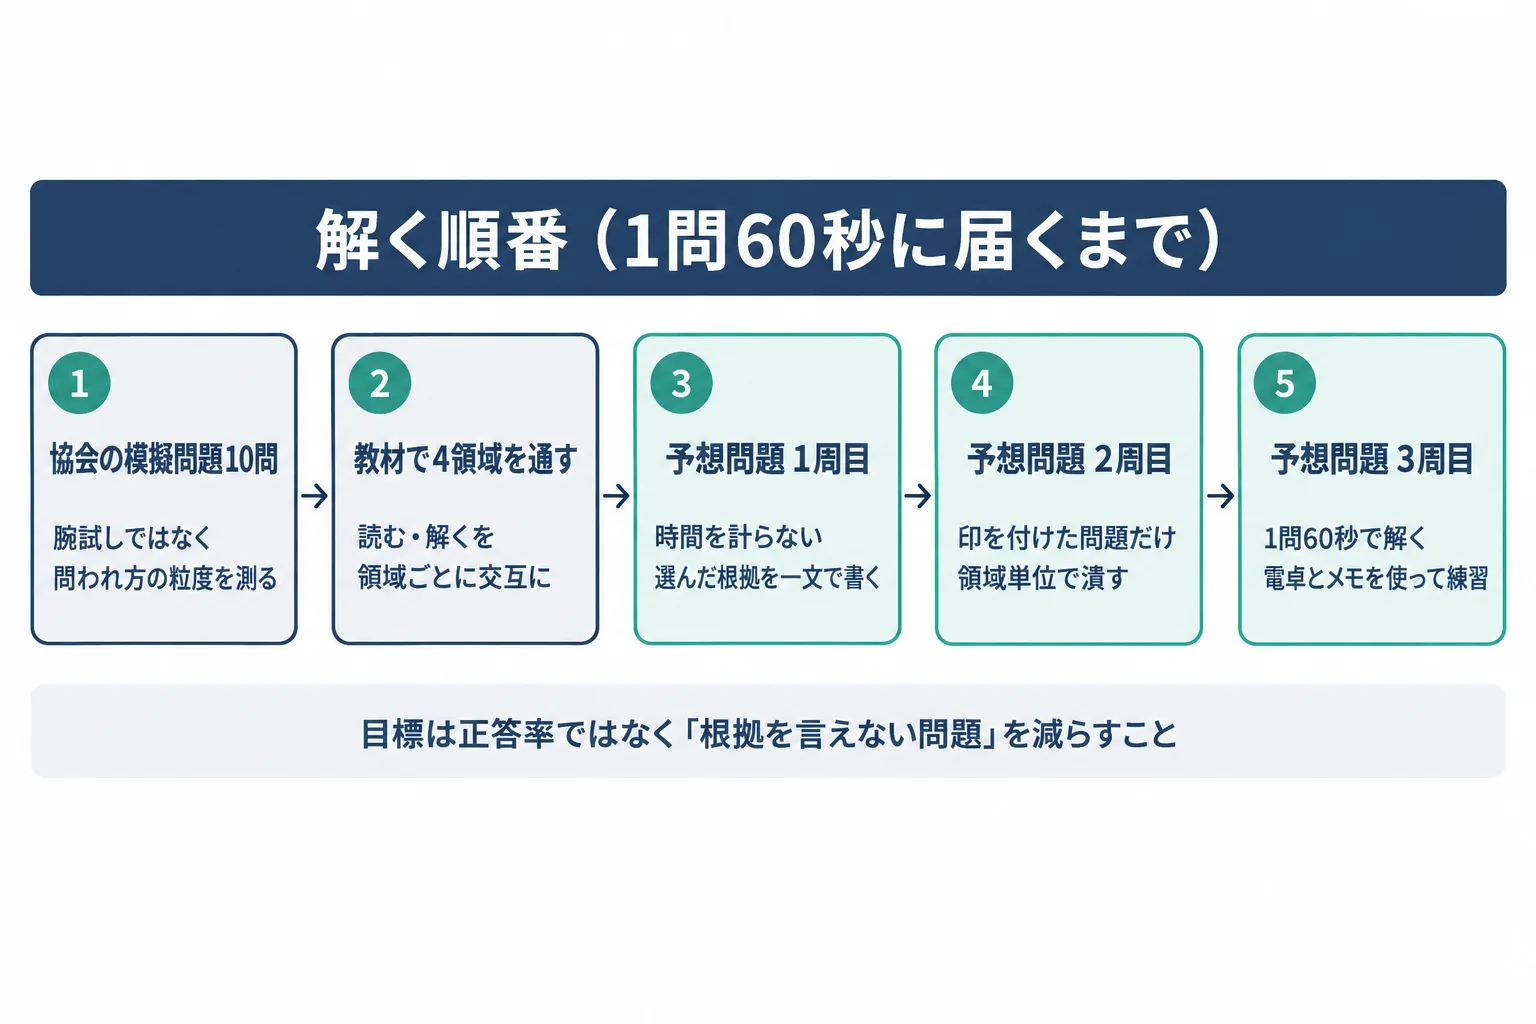
1周目:時間を計らず、根拠を一文で書く
最初は時間を無視してください。1問ごとに「なぜその選択肢を選んだか」を一文で書きます。書けなかった問題は、正解していても未習得として印をつけます。合格ラインが非公開である以上、点数よりこの印の数のほうが意味のある指標です。
2周目:印をつけた問題だけ、領域単位で潰す
印がついた問題を領域ごとに集めると、手薄な領域が1つか2つに絞られるのが普通です。そこだけ教材に戻ります。4領域を均等に回すより時間効率が上がります。
3周目:1問60秒を体に入れる
ここで初めて時間を計ります。60秒で決まらない問題は飛ばして次に進む練習です。飛ばす判断を先に体で覚えておくほうが、100問を最後まで回りきれます。計算問題は電卓とメモを使う前提で練習してください。本番で初めて画面上の電卓に触ると、それだけで数十秒を落とします。
演習を学習計画のどこに差し込むかは、データサイエンティスト検定の勉強法|出題4領域の順番と対策で扱っています。教材を1周してから問題に入るのではなく、領域ごとに読む・解くを交互に進めるほうが用語の切り分けが定着します。
領域別に間違えやすい論点
10問を解いたあとの見直しで、領域ごとに残りやすい間違いの型を整理します。ここは公開情報ではなく、出題範囲の構成から当編集部が整理した目安です。
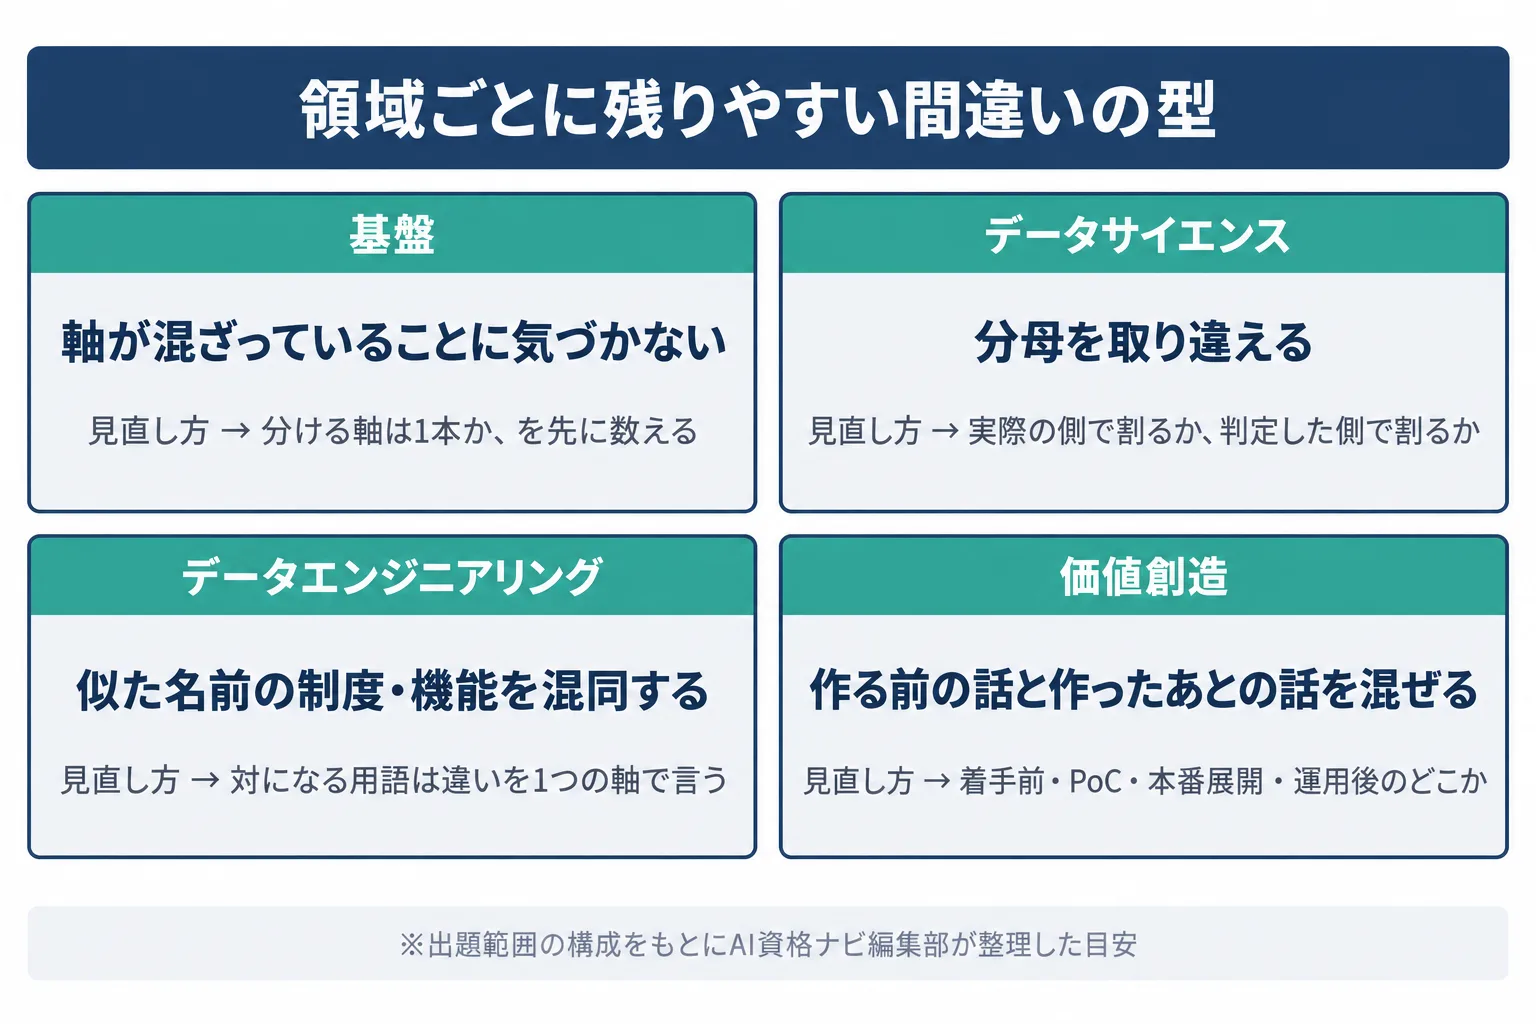
基盤:軸が混ざっていることに気づかない
MECE、構造化、KPIの設定は、いずれも「1本の軸で切れているか」を問われます。問1のように軸が2本混ざった選択肢は、内容が正しそうに見えても誤りです。統計情報の読み取りでは、相関と因果、割合と実数、平均と中央値のように、2つの概念を取り違えさせる作り方が定番です。
データサイエンス:分母を取り違える
適合率と再現率、正解率と特異度は、どれも分母が違うだけです。式を暗記するより、「実際の側で割るのか、判定した側で割るのか」を毎回口に出すほうが確実です。計算問題は電卓が使えるので、計算そのものより何を何で割るかの判断が問われていると考えてください。
データエンジニアリング:似た名前の制度・機能を混同する
仮名加工情報と匿名加工情報、WHERE と HAVING、構造化データと非構造化データのように、対になる用語が多い領域です。対になる用語は、必ず「何が違うのか」を1つの軸で言えるようにしておきます。軸が言えないまま両方の説明を丸暗記すると、選択肢で入れ替えられた瞬間に判別できなくなります。
価値創造:作る前の話と、作ったあとの話を混ぜる
2026年6月から新設された領域で、市販教材の対応が最も薄いところです。問題の多くは「いつの話か」で整理できます。着手前(課題の再定義・成功基準の合意)、PoC、本番展開、運用後(監視・再学習・ガバナンス)の4つの時点のどこの話かを先に判定すると、選択肢の取捨がはっきりします。この領域は協会の模擬問題4問に解説が付いているので、そちらを優先してください。
よくある失敗4つ
失敗1:「過去問」を名乗る資料を本物だと思って解く
協会が公開しているのは模擬問題10問だけで、実際に出題された問題は公開されていません。「過去問」と表示されているものは、出題範囲にもとづく予想問題か、受験者の記憶にもとづく再現である可能性があります。後者は内容の正確さを誰も保証していません。出所が書かれていない問題は、答えの根拠を自分で公式の範囲に当たって確認してください。
失敗2:ver.5以前の教材のまま、価値創造を素通りする
2026年9月時点の出題範囲はスキルチェックリストver.6にもとづいており、協会は「従来のビジネス力を問う問題の多くは基盤スキルの問題に移行します」「価値創造スキルを問う問題が新規に加わります」と告知しています。手元の教材がどの版を前提にしているかは必ず確認してください。版が古いと、範囲がずれていることにそもそも気づけません。
失敗3:正答率だけを見て仕上がりを判断する
協会は合格ラインを非公開としています。実施結果ページの「約76%」はあくまで回ごとの参考値で、しかも「試験問題は各試験回によって少しずつ刷新されます」という注釈が付いています。問題集で8割取れたことは、その問題集に対する正答率でしかありません。領域ごとに「根拠を言えない問題が残っているか」で見てください。
失敗4:電卓とメモが使えることを知らないまま練習する
CBT-Solutionsは、計算問題では画面上の電卓が使えること、会場で筆記用具とメモ用紙が渡されることを案内しています。暗算で解く練習をしていると、本番で手順が変わります。逆に、メモに混同行列の4マスを書き出す、データを小さい順に並べ替える、といった手を動かす解き方を練習段階から組み込んでおくと、60秒の使い方が安定します。当日の持ち物や進行はデータサイエンティスト検定の受験の流れ|申込・当日・結果にまとめました。
まとめ
2026年9月時点の整理です。データサイエンティスト協会は過去に出題された問題を公開しておらず、公開されているのは ver.6 対応の模擬問題10問(基礎1問/価値創造4問/データサイエンス3問/データエンジニアリング2問)だけです。だから「過去問を集める」のではなく、模擬問題で問われ方の粒度を測り、そのあとは出題範囲の4領域に沿った予想問題・練習問題で用語の切り分けを確認する、という順番になります。
領域別の出題比率は公表されていません。模擬問題の内訳と、「従来のビジネス力の問題の多くは基盤に移行し、価値創造が新規に加わる」という協会の告知が、現時点で公開されている手がかりのすべてです。
合格ラインも非公開で、実施結果ページの約76%は参考値です。正答率を目標に置くより、「根拠を言えずに選んだ問題が、どの領域に何問残っているか」を数えてください。時間配分は1問あたり60秒。計算問題は画面上の電卓とメモ用紙を使う前提で、この速度で迷わず進める領域を増やしていくのが演習の目的です。
受験料や教材費の見積もりはデータサイエンティスト検定の費用|受験料と教材・講座の公開価格、社員にまとめて受けさせる場合の進め方はDS検定を社員に受けさせる進め方|団体申込と費用の見方で扱っています。
よくある質問
Q1. DS検定の過去問は、どこかで手に入りますか。
2026年9月時点で、データサイエンティスト協会が公開しているのは模擬問題10問です。過去に出題された問題を公開している公式の場所はありません。また協会は合格ラインを非公開としているため、仮に問題を集められたとしても合否の基準を自分で再現することはできません。模擬問題10問を精読したうえで、出題範囲に沿った予想問題・練習問題で領域をつぶすのが現実的な進め方です。
Q2. 予想問題は何問くらい解けば足りますか。
公表されている基準がないため、「何問で足りる」とは言えません。問題数ではなく領域で考えてください。基盤・データサイエンス・データエンジニアリング・価値創造の4領域すべてについて、根拠を説明できる状態で解ける問題が続くようになっていれば、範囲としては一通り触れた状態です。逆に500問解いても特定の領域に印が残っているなら、そこが未習得です。
Q3. 他の資格の予想問題で練習しても、DS検定の対策になりますか。
重なる部分はありますが、そのままでは足りません。DS検定はSQLやデータ加工などのデータエンジニアリング領域と、2026年6月に新設された価値創造領域が出題範囲に入っており、この2つは他の資格ではあまりカバーされません。参考までに、同じ形式で整理した他資格の演習記事としてG検定の予想問題10問|分野別の解き方と間違えやすい論点と生成AIパスポートの予想問題12問|章別の解き方と落とし穴があります。